The CollBook
This work is licensed under a Creative Commons Attribution 4.0 International License (CC BY 4.0). This means you are free to share, copy, redistribute, and modify this book under the following terms:
-
Attribution: Credit must be given to the original authors and contributors.
-
No Additional Restrictions: You cannot impose legal restrictions that prevent others from using the book freely under the same terms.
Free Digital Version Available. This book is freely available online at https://mkurnosov.github.io/collbook/ under the Creative Commons license.
For more information on the Creative Commons license, visit: https://creativecommons.org/licenses/by/4.0/.
Printed edition: Курносов М.Г. Алгоритмы коллективных операций стандарта MPI. - Москва: Горячая Линия - Телеком, 2025. - 288 с. ISBN 978-5-9912-1149-9.
© 2025 Mikhail Kurnosov.
Предисловие
Стандарт MPI (Message Passing Interface) и библиотеки реализующие его остаются на протяжении нескольких десятков лет основным средством разработки параллельных программ для высокопроизводительных вычислительных систем с распределенной памятью. Значительное место в стандарте занимает описание коллективных коммуникационных операций, или групповых, глобальных, в которых участвуют все или часть процессов программы. Время их выполнения для многих приложений является критически важным.
Монография, которую вы читаете, – это попытка автора систематизировать и изложить наиболее значимые алгоритмы коллективных операций MPI. Большая часть книги посвящена алгоритмам, которые не учитывают архитектурных свойств вычислительных систем, а опираются лишь на пару двусторонних примитивов передачи Send и приема Recv сообщений. Такие алгоритмы формируют базис для построения более сложных архитектурно-ориентированных методов коллективных операций, построения высокопроизводительных коммуникационных сетей со специализированными топологиями и протоколами канального уровня. Актуальность этих алгоритмов не угасает, с каждым витком развития архитектуры вычислительных систем происходит возврат к базовым алгоритмам и их реализация с учетом текущего уровня развития коммуникационных и процессорных технологий.
Отражены основные подходы построения алгоритмов коллективных операций для систем определенных классов: для системы с общей памятью, иерархические алгоритмы для систем с многоуровневой иерархией памяти и коммуникационной сети. Изложена специфика реализации неблокирующих коллективных операций в библиотеках MPI – построение расписаний и продвижение их выполнения. В конце книги затрагивается вопрос экспериментальной оценки эффективности коллективных операций.
Часть монографии составили результаты исследований, выполненных автором в Сибирском государственном университете телекоммуникаций и информатики (г. Новосибирск) и Институте физики полупроводников им. А.В. Ржанова Сибирского отделения РАН. Описанные практические аспекты реализации алгоритмов опираются на опыт участия автора и его аспирантов в международном проекте Open MPI (компоненты coll/base, coll/libnbc), а также некоторые подходы, которые реализованы автором в серии библиотек структурно-ориентированных алгоритмов коллективных операций MPI по заказу компании Huawei.
Материал книги использовался в курсе лекций "Параллельные вычислительные технологии", который автор читал студентам бакалавриата и магистратуры в Сибирском государственном университете телекоммуникаций и информатики.
В своей профессиональной деятельности автору довелось общаться с большим количеством талантливых людей. Автор благодарен своему научному руководителю чл.-корр. РАН В.Г. Хорошевскому, коллегам по Кафедре вычислительных систем Сибирского государственного университета телекоммуникаций и информатики, а также сотрудникам Лаборатории вычислительных систем Института физики полупроводников им. А.В. Ржанова Сибирского отделения РАН.
Глубокую признательность и благодарность автор выражает всем, кто принял участие в обсуждении рукописи монографии: к.т.н. Полякову Артему Юрьевичу (стандарт PMIx, проекты OpenPMIx, Open MPI; NVIDIA), Аненкову Александру Дмитриевичу (YADRO), д.т.н. Шидловскому Станиславу Викторовичу (Томский государственный университет), к.т.н. Кулагину Ивану Ивановичу (Институт системного программирования им. В.П. Иванникова РАН), д.т.н. доценту Павскому Кириллу Валерьевичу (Институт физики полупроводников им. А.В. Ржанова СО РАН), к.т.н. доценту Пазникову Алексею Александровичу (National University of Singapore).
Автор выражает надежду, что возможные неточности и опечатки в тексте не станут непреодолимой преградой для восприятия основных идей. Замечания, предложения и комментарии можно направить по адресу mkurnosov[at]yandex.ru.
С уважением, Михаил Курносов
профессор, доктор технических наук
г. Новосибирск
1. Введение
Как следует из названия, Message Passing Interface (https://www.mpi-forum.org), определяет программный интерфейс библиотек высокопроизводительной передачи сообщений. Включает операции двусторонних обменов (point-to-point), односторонних обменов (one-sided remote memory access) и коллективные операции. Вводит понятия группы процессов, коммуникаторов, виртуальных топологий и производных типов данных. Основное предназначение стандарта – обеспечить возможность создания параллельных программ, переносимых на уровне исходного кода между вычислительными системами различных архитектур и конфигураций: с общей и распределенной памятью, на базе заказного оборудования и свободно доступного на рынке, с процессорами общего назначения и/или специализированными ускорителями.
Изначальная мотивация создания стандарта – сложность переносимости параллельных программ между различными архитектурами вычислительных систем. К 1992 году каждый производитель высокопроизводительных вычислительных систем (Thinking Machines, NEC, Intel, Cray, Fujitsu, Hitachi), как правило, поставлял свою реализацию сред параллельного программирования, которые включали механизмы управления процессами и предоставляли операции двусторонних и коллективных обменов информацией. Можно выделить следующие проекты и программные системы, которые оказали значительное влияние на становление MPI: проект PVM (Parallel Virtual Machine) – открытая библиотека и среда времени выполнения для создания параллельных программ в модели передачи сообщений (двусторонние и ряд коллективных операций, уведомления об отказах), разработка Окриджской национальной лаборатории США (ORNL); проекты p4 (Аргонская национальная лаборатория США, ANL), Intel NX/2, IBM EUI, nCUBE Vertex, Zipcode, PARMACS, Express, Chimp, PICL, Chameleon.
Желание обобщить накопленный опыт и сформировать устойчивый интерфейс для создания параллельных программ привел в 1992 году к возникновению инициативной группы специалистов – MPI Forum, которая включала более 40 организаций и 60 человек. В мае 1994 года была опубликована первая версия стандарта, которая включала блокирующие и неблокирующие функции двусторонних обменов, коллективные операции, управление группами процессов и коммуникаторами, виртуальные топологии и производные типы данных. Эталонная реализация стандарта (reference implementation) вышла в 1996 году – библиотека MPICH. В июле 1997 года закончена работа и опубликован стандарт MPI 2.0, который включал функции односторонних обменов (one-sided communication), динамического порождения процессов, параллельный ввод-вывод (MPI I/O), интерфейсы для C и Fortran 90. Значительные изменения в стандарте произошли в версии MPI 3.0, которая опубликована в сентябре 2012 года. Основные изменения коснулись введения неблокирующих коллективных операций (nonblocking collective operation), разреженных коллективных операций (sparse collectives), расширения возможностей односторонних обменов, удалена поддержка интерфейса для С. В июне 2021 года вышел MPI 4.0, который расширил интерфейс операциями с поддержкой large-count, решающий проблему переполнения знакового типа int для элементов count, коллективные операции с не меняющимися аргументами (persistent collectives), разделенные коммуникационные операции для многопоточных программ (partitioned communications) и модель сессий для инициализации MPI-программ (MPI Session).
Автор считает важным отметим, что в СССР и России велись и ведутся работы по созданию отечественных вычислительных систем с распределенной памятью и систем параллельного программирования для них: вычислительные системы с программируемой структурой (Минск-222, семейство МИКРОС) [1],[2],[3],[4],[5] , семейство систем МВС [6] , вычислительные системы со специализированными топологиями коммуникационных сетей [7],[8], реконфигурируемые вычислительные системы [9] . Автор монографии является членом научной школы по распределенным вычислительным системам с программируемой структурой, основателем которой является чл.-корр. РАН В.Г. Хорошевский. В начале 1960-х годов в Институте математики Сибирского отделения РАН были инициированы работы по созданию вычислительных систем с распределенной памятью на базе серийных ЭВМ. Для их сопряжения в систему были разработаны аппаратные системные устройства, поддерживающий основные типы коммуникационных операций: двусторонние обмены и коллективные операции: трансляционный обмен (one-to-all), коллекторный прием (all-to-one) и трансляционно-циклический обмен типа "каждый-всем" (all-to-all). Заинтересованный читатель может найти дополнительную информацию в следующих работах [1],[2],[3],[5] .
В центре внимание данной книги часть стандарта MPI – алгоритмы коллективных операций обмена информацией. В следующих главах дается краткое изложение основных понятий стандарта, приводится описание моделей для оценки эффективности алгоритмов и начинается систематическое описание алгоритмов.
2. Основные понятия стандарта MPI
Рассмотрим основные понятия стандарта, которые понадобятся нам при рассмотрении алгоритмов коллективных операций.
2.1. Коммуникаторы
После инициализации библиотеки при помощи операций MPI_Init, MPI_Init_thread или механизма сессией MPI_Session_init каждому процессу известен коммуникатор (communicator) из \(p\) процессов. Каждый процесс имеет уникальный номер, ранк (rank), из множества \(\{0, 1, \ldots, p-1\}\). Стандарт предоставляет функции порождения новых коммуникаторов, включая группировку процессов в соответствии с иерархией памяти вычислительных узлов (например, MPI_Comm_split_type). На протяжении всей книги мы будем рассматривать только интра-коммуникаторы, так как интер-коммуникаторы редко применяются на практике.
2.2. Блокирующие операции Send/Recv
Рассмотрим две базовые операции Send и Recv. Операция Send выполняет передачу процессу \(dest\) сообщения с тегом \(tag\). Сообщение для отправки располагается в памяти начиная с адреса \(sbuf\) и состоит из последовательно расположенных \(scount\) элементов типа \(sdtype\).
MPI_Send(sbuf, scount, sdtype, dest, tag, comm)
MPI_Recv(rbuf, rcount, rdtype, source, tag, comm, status)
Выполнение процесса-отправителя блокируется в Send до тех пор, пока \(sbuf\) нельзя будет использовать повторно – пока сообщение из \(sbuf\) не будет скопировано библиотекой в служебный буфер или не будет отправлено получателю. Прием сообщений выполняется операцией Recv, которая требует указания адреса \(rbuf\) буфера-приема и способа размещения полученных данных в памяти, который задается параметрами \(rcount\) и \(rdtype\). Типы \(sdtype\) и \(rdtype\) могут не совпадать на стороне отправителя и получателя. Стандарт требует равенства размеров сообщений:
Если процесс передает сообщение производного типа данных с не непрерывно размещенными в памяти элементами базовых типов (non-continuous datatype), то библиотека может выполнять предварительную упаковку сообщения в непрерывный буфер. Аналогично, при получении сообщения имеется непрерывная последовательность, которая разворачивается в \(rbuf\) в соответствии с описанием типа \(rdtype\). В параметре \(status\) сохраняется ранк отправителя, тег и реальный размер принятого сообщения.
Любой производный тип данных MPI рекурсивно строится на основе предопределенных базовых типов (MPI_DOUBLE, MPI_INT и др.). Формально производный тип данных задается картой типа (type map) – последовательностью пар \((type_0, disp_0), (type_1, disp_1), \ldots, (type_{n-1}, disp_{n-1})\), где \(type_i\) – базовый тип, \(disp_i\) – смещение в байтах относительно начала буфера в памяти. Например, мы можем отправить строку матрицы как непрерывную последовательность из 100 элементов MPI_DOUBLE, а на стороне получателя построить производный тип данных и принять операцией Recv 100 элементов в виде столбца матрицы с хранением по строкам (row-major).
Упаковка сообщения для типа с несмежными элементами в памяти (например, столбец матрицы) требует выполнения копирования отдельных блоков в непрерывный буфер. Это является причиной накладных расходов при использовании производных типов. За упаковку в непрерывный буфер отвечает библиотека, но это можно реализовать и на стороне приложения, например циклом копирования элементов или операцией MPI_Pack [10],[11].
2.3. Неблокирующие операции Isend/Irecv
Неблокирующие операции Isend/Irecv позволяют инициировать запрос (request) на выполнение коммуникационной операции. Проверка состояния операции, завершена или выполняется, реализуется операцией Test. Дождаться завершения ассоциированной с запросом операции можно блокирующим вызовом Wait.
MPI_Isend(sbuf, scount, sdtype, dest, tag, comm, request)
MPI_Irecv(rbuf, rcount, rdtype, source, tag, comm, request)
MPI_Test(request, flag, status)
MPI_Wait(request, status)
Неблокирующие операции позволяют реализовать в программе совмещение (перекрытие, overlap) коммуникационной операции и вычислений, которые следуют после неблокирующего вызова и не используют буфер операции. Эффективность совмещения зависит от аппаратной конфигурации целевой системы, в какой степени нижележащий коммуникационный слой и/или сетевой адаптер поддерживает аппаратную реализацию коммуникационных операций.
В большинстве реализаций библиотек MPI блокирующие операции двусторонних обменов реализуются на базе неблокирующих. Операция Send реализуется вызовов Isend, за которым сразу следует Wait. За выполнение коммуникационных операций, связанных с запросами, отвечает подсистема продвижения (MPI progress engine) [12] . Библиотека поддерживает в каждом процессе несколько типов очередей запросов [13],[14] . При вызове Isend создается запрос на выполнение неблокирующей коммуникационной операции, он помещается в очередь Send-Request-Queue (SRQ). Аналогично, при вызове Irecv запрос помещается в очередь Recv-Request-Queue (RRQ). Если сообщение достаточно большое и нижележащий коммуникационный уровень (TCP/IP, RoCE, InfiniBand) требует нескольких обращений к своим коммуникационным примитивам, то библиотеке MPI необходимо каким-то образом выполнять эти действия между вызовами Isend/Irecv и Wait. Для этого пользователю предоставляются функции проверки состояния запросов Test, которые запускают часть еще невыполненных коммуникационных шагов, связанных с запросом и возвращает его состояние пользователю. Операция Wait блокируется до тех пор, пока цикл обращений к подсистеме продвижения, не закончит выполнение операции, а запрос не перейдет в состояние завершенный (complete). Описанная схема – это синхронное продвижение коммуникационных операций путем явного вызова пользователем Test. Альтернативный вариант – библиотека для каждого процесса запускает поток, который асинхронного продвигает запросы. В этом случае пользователю не требуется явно вызывать Test для продвижения операций, но за это приходится платить накладными расходами на поддержание дополнительного потока, который будет делить процессорное ядро с потоком пользователя. Библиотеки Open MPI и MPICH по умолчанию собираются в режиме синхронного продвижения запросов, без выделенного потока.
2.4. Поиск поступивших сообщений
При вызове операции Recv/Irecv библиотека запускает процедуру поиска поступивших сообщений (tag matching). Рассмотрим ситуацию, которая объясняет наличие в библиотеках MPI двух типов протоколов для реализации двусторонних обменов, eager и rendezvous [15] . Процесс 0 выполняет передачу сообщения процессу 1. Процесс 1 по какой-то причине выполняет вызов операции Recv намного позже, чем по каналу связи поступило сообщение от процесса 0. Возникает вопрос – в какой буфер библиотека MPI должна сохранить поступившее сообщение процесса 0? Адрес буфера приема \(rbuf\) пользователь сообщить не успел. Очевидное решение – библиотека создает в каждом процессе очередь непредвиденных сообщений Unexpected-Message-Queue (UMQ) из \(n\) буферов фиксированного размера по \(s\) байт. Параметры \(n, s\) являются настраиваемыми, их значение известно в каждом процессе. Логика работы библиотеки для операций Send/Recv разделяется на два случая – сообщения не превышающие \(s\) байт передаются протоколом \(eager\), а сообщения больше \(s\) протоколом \(randezvous\) c предварительным установлением соединения для выделения буфер необходимого размера. Рассмотрим отдельные шаги этих протоколов.
2.4.1. Протокол Eager
Пользователь вызвал Send. Если сообщение не превышает \(s\) байт оно отправляется одной операцией получателю.
Поступление сообщения в процесс. Событие регистрируется подсистемой продвижения, асинхронным потоком или синхронными вызовами Test. Библиотека проверяет очередь RRQ запросов ранее вызванных операций Recv, выполняет поиск подходящего запроса операции приема. Эта процедура называется tag matching – сопоставление параметров поступившего сообщения и запросов в очереди. Проверяется совпадение коммуникатора, ранка отправителя, если в Recv не передано значение MPI_SOURCE_ANY, и тега, если не указано MPI_TAG_ANY. Если подходящий запрос найден, сообщение копируется в буфер пользователя \(rbuf\), который ассоциирован с найденным запросом. Если запрос не найден в RRQ, сообщение копируется в свободный буфер очереди UMQ.
Пользователь вызвал Recv. Выполняется поиск сообщения в очереди UMQ. Каждое сообщение в очереди UMQ сопоставляется c параметрами операции Recv. При успешном сопоставлении выполняется копирование из временного буфера UMQ в буфер \(rbuf\) пользователя. Важно отметить, это второе копирование сообщения с момента его поступления в процесс (коммуникационный слой \(\rightarrow\) UMQ \(\rightarrow\) \(rbuf\)). Если сообщение не найдено в UMQ. Значит оно еще не поступило. Выполняется добавление запроса Recv в очередь RRQ. В случае Irecv запрос возвращается пользователю, а при блокирующем вызове Recv управление передается циклу обращений к подсистеме продвижения операции пока сообщение не поступит в процесс.
Очевидная рекомендация пользователям MPI – вызывать Recv/Irecv как можно раньше, до парной операции отправки, чтобы минимизировать вероятность увеличения очереди UMQ. На поиск сообщения в очереди UMQ требуется время пропорциональное её длине, а в худшем случае она может вырасти до числа процессов в коммуникаторе. Например, если \(p - 1\) процессов отправили короткие сообщение одному процессу, а он вызвал все операции Recv с опозданием, то его очередь UMQ будет содержать \(p - 1\) сообщений, а поиск в ней будет занимать время \(O(p)\) [16] .
2.4.2. Протокол Randezvous
Пользователь вызвал Send. Размер сообщения больше \(s\). Отправитель передает получателю сообщение, в котором содержится размер отправления \(scount \cdot \textrm{sizeof}(sdtype)\).
Получатель принимает сообщение. Выделяет буфер необходимого размера (если буфер пользователя не найден в RRQ) и передает отправителю подтверждение Ready-to-Send (RTS).
Отправитель получает RTS и передает полное сообщение получателю.
Получатель принимает сообщение в буфер.
Реализация сопоставления может быть реализована программными методами, как описано выше, или полностью или частично поддерживаться сетевым оборудованием (hardware tag matching).
2.5. Структура библиотек MPI
Библиотеки MPI имеют многоуровневую организацию для абстрагирования от архитектуры целевой системы. Как правило, на нижнем уровне присутствует слой поддержки базовых коммуникационных операций конкретной сетевой технологии или транспортного механизма. Например, реализация коммуникационных примитивов Send/Recv средствами протоколов TCP/IP, InfiniBand, через общую память или через сторонние библиотеки (OpenUCX, libfabric). Подсистемы уровня выше используют эти примитивы для реализации коммуникационных операций уже с учётом семантикой стандарта MPI. Например, Open MPI имеет модульную компонентную архитектуру [17],[18] . Она включает несколько отдельных подсистем (проектов):
-
Open MPI (OMPI): реализует функции стандарта MPI, интерфейсы для языков C, Fortran;
-
Open Portability Access Layer (OPAL): предоставляет архитектурно-независимые функции работы с сегментами общей памяти, динамического выделения памяти, атомарные операции, управление потоками;
-
PMIx Runtime Reference Environment (PRRTE): внешний проект, обеспечивает запуск процессов, их привязку к процессорным ядрам и NUMA-узлам (используется библиотека HWLOC) [19] .
Среди основных подсистемы Open MPI (frameworks) можно выделить следующие:
-
BTL (Byte Transport Layer): компонент предоставляет базовые функции передачи сообщений для различных типов протоколов и сред передачи (TCP/IP, InfiniBand, shared memory), его функции используются на уровне PML;
-
PML (Point-to-Point Messaging Layer): реализует функции двусторонних обменов в соответствии с семантикой MPI;
-
coll: подсистема реализации алгоритмов коллективных операций;
-
OSC (One-Sided Communication): реализация функций односторонних обменов MPI.
Каждая подсистема Open MPI может иметь несколько различных реализаций специфичных для конкретных видов коммуникационных сетей и процессорных архитектур. Например, PML включает альтернативные компоненты ucx и ob1 для операций Send/Recv. Выбор компонента можно осуществить при запуске приложения:
$ mpirun --mca pml ucx ./mpiappАналогичная ситуация с подсистемой ompi/coll, которая включает различные компоненты реализации коллективных операций [20],[21],[22] :
-
basic: реализация коллективных операций на базе двусторонних обменов подсистемы PML, набор базовых алгоритмов, без учёта топологии сети;
-
base (tuned): реализация коллективных операций на базе двусторонних обменов подсистемы PML (эффективные алгоритмы с поддержкой деревьев различных видов, сегментация сообщений и конвейеризация их передачи) [20] ;
-
ucc: реализация коллективных операций средами внешней библиотеки Open UCC;
-
hcoll: реализация коллективных операций для коммуникационного оборудования NVIDIA/Mellanox, передаёт управление закрытой библиотке hcoll) [21] ;
-
han: реализация двухуровневых иерархических алгоритмов для некоторых операций, оптимизация времени выполнения за счет группировка процессов одного узла и выполнения обменов между ними [22] ;
-
sm: реализация коллективных операций в пределах одного вычислительного узла через общую память (shared memory) [23] .
При создании нового коммуникатора библиотека опрашивает все компоненты подсистемы coll на предмет способности их функционирования на этом коммуникаторе, заданном числе процессов. Для коммуникатора формируется таблица указателей на коллективные операции. Операции могут быть из разных компонентов, так не все из них реализуют полный набор функций. Таблица заполняется в порядке невозрастания приоритетов компонентов. При запуске приложения можно явным образом задать больший приоритет нужного компонента. Например, следующим образом можно задать приоритет 100 компоненту coll/tuned:
$ mpirun --mca coll_tuned_priority 100 ./mpiappПри вызове коллективной операции управление будет передаваться в компонент, который был выбран на этапе построения таблицы указателей для коммуникатора. Практический все компоненты для каждой коллективной операции включают несколько алгоритмов реализации. Посмотреть список параметров компонента tuned и алгоритмов можно следующей командой (показан фрагмент вывода для операции Bcast):
$ ompi_info --param coll tuned --level 9
  MCA coll tuned: parameter "coll_tuned_bcast_algorithm"
  Which bcast algorithm is used. Can be locked down to choice of:
  0 ignore, 1 basic linear, 2 chain, 3 pipeline, 4 split binary tree,
  5 binary tree, 6 binomial tree, 7 knomial tree, 8 scatter_allgather,
  9 scatter_allgather_ring.
  Only relevant if coll_tuned_use_dynamic_rules is true.
Принудительный выбор алгоритма коллективной операции выполняется установкой соответствующего параметра. Выберем алгоритм бинарного дерева для операции Bcast компонента tuned:
$ mpirun --mca coll_tuned_priority 100 \
         --mca coll_tuned_use_dynamic_rules true \
         --mca coll_tuned_bcast_algorithm 5 ./app
По умолчанию коллективная операция самостоятельно принимает решение о выборе алгоритма ей реализации из доступных в компоненте. Выбор осуществляется на основе переданных параметров: размере сообщения, типе данных элементов, числа процессов. Эта процедура известна как задача выбора алгоритма коллективной операции (collective algorithm selection) [24],[25] . Например, компонент tuned по умолчанию выбирает алгоритм исходя из предварительных измерений на вычислительном кластере его разработчиков. Очевидно, что такой выбор не для всех вычислительных систем будет оптимальным. Об этом надо помнить при использовании библиотек MPI и оценки эффективности алгоритмов коллективных операций, например тестами OSU MPI Benchmarks, Intel MPI Benchamarks. При вызове коллективной операции для различных размеров сообщений могут вызываться разные алгоритмы и на графиках времени выполнения могут появиться резкие скачки, причиной которых могут быть переключения на другой алгоритм.
Переключения на другой алгоритм могут происходить даже если пользователь задал через runtime-параметры конкретный алгоритм коллективной операции. Например, пользователем выбран алгоритм 6 для операции Allreduce и запущен на 10 процессах, но алгоритм 6 может не поддерживать некоммутативные бинарные операции или число процессов не равное степени двойки, в таком случае он передает управлению алгоритму по умолчанию или компоненту с предшествующим приоритетом. Обнаружить подобные переключения можно включив отладочный вывод:
$ mpirun --mca coll_base_verbose 100 \
         --mca coll_tuned_use_dynamic_rules true \
         --mca coll_tuned_allreduce_algorithm 6 \
         ./app

coll:base:allreduce_intra_redscat_allgather: rank 0/10
count 1000 switching to basic linear allreduce
2.6. Подходы к реализации алгоритмов коллективных операций
Каждая используемая в промышленности и исследованиях библиотека MPI включает различные виды алгоритмов коллективных операций. Которые отличаются уровнем специализации на конкретной коммуникационной технологии или сетевой топологии.
2.6.1. Алгоритмы без учета топологии коммуникационной сети
Такие алгоритмы строятся на базе операций Send/Recv и не учитывают топологических свойств коммуникационной сети. Поэтому их называют плоскими (flat) [26],[27],[28],[29],[30] . Они основаны на простейшей модели коммуникационной сети: на каждом вычислительном узле имеется сетевой интерфейс с одним портом (1-port model), сетевой интерфейс позволяет выполнять одновременную передачу одного сообщения и приём другого (full duplex), каждый из \(p\) процессов может передавать и принимать сообщения от любого, топология системы и маршрутизация игнорируются. Алгоритмы обладают переносимостью между широким спектром вычислительных систем, но не обеспечивают достижения предельной производительности. Для поддержки нового типа систем достаточно иметь реализацию примитивов Send и Recv. Из техник оптимизации применяется сегментация сообщения на фрагменты с их конвейерной передачей/приемом для полноценного задействования полнодуплексного режима сетевых интерфейсов. Кроме того, такие алгоритмы служат строительными блоками для многоуровневых (иерархических) алгоритмов, которые на разных уровнях коммуникационной среды задействуют различные подходы. Например, в иерархическом алгоритме Bcast между узлами может использоваться плоский алгоритм биномиального дерева, а в пределах каждого узла – линейный алгоритм (linear/flat tree). Известные примеры реализации таких алгоритмов: компонент coll/tuned (coll/base) в Open MPI и алгоритмы в библиотеке MPICH.
2.6.2. Алгоритмы для фиксированной сетевой топологии
Алгоритмы этого класса также строятся на основе примитивов Send и Recv, но пытаются учесть все или некоторые архитектурные свойства коммуникационной сети: топологию соединений узлов (fat-tree/spine-leaf, \(m\)-ary \(n\)-cube, m-ary n-hypercube, Dragonfly, circulant network), особенности алгоритмов маршрутизации и управления перегрузками в сети, иерархию коммункационных уровней (общая память в пределах узла и сеть межмашинных связей) [31],[32],[33] . В литературе их называют структурно-ориентированные алгоритмы или алгоритмы, учитывающие топологию целевой системы (topology-aware collectives). К рассматриваемому типу алгоритмов относятся иерархический алгоритмы коллективных операций (hierarchical collectives, multilevel collectives) [34] . Они составляют основу компонентов Open MPI coll/hcoll (ранее известный как Cheetah) [35] , coll/han [22] ; и SMP collectives в библиотеках MPICH, MVAPICH [36] . Сюда же можно отнести коллективные операции с обменами через разделяемую память одного многопроцессорного узла [23],[37],[38],[39] .
2.6.3. Алгоритмы с аппаратной реализацией
Такие алгоритмы имеют полную или частичную аппаратную реализацию (hardware-accelerated collectives). В свою очередь библиотеки MPI выполняют минимальную работу – проброс обращений к поставляемой производителем библиотеке поддержки коллективных операций. Подобные алгоритмы обладают высокой производительностью, но имеют ограничения. Например, могут не поддерживать производные типы данных MPI или пользовательские операции редукции. Следующие коммуникационные технологии служат примером таких систем: NVIDIA/Mellanox SHARP [21] , IBM BlueGene/P tree network, HPE/Cray Slingshot.
В этой книге мы сосредоточим свои внимание на алгоритмах первого типа, на базе операций Send/Recv без учета топологии коммуникационной сети.
2.7. Классификация коллективных операций
2.7.1. Блокирующие коллективные операции
Блокирующие коллективные операции имеют наибольшее распространение в MPI-приложениях и определены в стандарте с его первых версий. Они блокируют выполнение процесса до тех пор, пока буфер отправки не будет доступен для повторного использования. При выходе из функции пользователю неизвестно завершены ли все коммуникации относящиеся к коллективному вызову. Ниже приведён пример прототипа блокирующей функции MPI_Bcast.
MPI_Bcast(buf, count, datatype, root, comm)В подавляющем большинстве библиотек алгоритмы блокирующих операций динамически формируют расписание выполняемых обменов между процессами коммуникатора. Например, в алгоритме бинарного дерева операции Bcast при каждом вызове вычисляется номер процесс родителя в дереве и дочерние узлы. Очевидно, что здесь возможна оптимизация за счет предварительного вычисления некоторых параметров алгоритмов (структуры дерева обменов) на этапе создания коммуникатора. Но на этом этапе неизвестны значения аргументов коллективной операции: номер корневого процесса, размер сообщения, тип данных элементов и будет ли она вызвана. Конечно, возможна разработка и применение различных инструментов предварительного профилирования и сбора информации об используемых в приложении коллективных операциях и значениях их аргументов. Например, Intel MPI Tune. В целом создание простейшей библиотеки профилирования, а именно перехвата функций MPI, может быть лего реализовано через стандартизированный интерфейс MPI Profiling.
2.7.2. Неблокирующие коллективные операции
Неблокирубщие коллективные операции (nonblocking collectivs) появились в стандарте MPI 3.0 [40] . Основная мотивация их добавления в стандарт – предоставление стандартного интерфейса для организации совмещения коллективных обменов и вычислений. Эффективность совмещения (перекрытия, overlap) в значительной степени зависит от эффективности реализации неблокирующих коллективных операций в библиотеке (структура расписаний обменов и механизм их продвижения), их поддержке со стороны коммуникационной сети, сетевых адаптеров.
MPI_Ibcast(buf, count, datatype, root, comm, request)
while (!flag) {
    // Вычисления, совмещение с Ibcast
    MPI_Test(request, flag, status)
}
MPI_Wait(request, status)
При вызове неблокирующей коллективной операции каждый процесс формирует расписание обменов (collective schedule), соответствующе выбранному алгоритму. Расписание и метаданные его выполнения связываются с запросом (request). В библиотеке Open MPI coll/libnbc расписание – это список элементарных операций (Send, Recv, Reduce), которые должен выполнить процесс. В расписании может присутствовать операция барьера – она ожидает завершения предыдущих операций. Например, перед выполнением передачи буфера дочерним процессам его надо получить от родителя. Поэтому в расписание добавляется барьер перед операцией Send. В библиотеке MPICH (подсистема TSP) расписание реализовано в виде направленного ациклического графа, в котором вершины – элементарные операции, а ребра отражают зависимости по входным данным. Так как расписание создается до фактического выполнения обменов, то все временные буферы надо создать заранее. Кроме этого необходимо вычислить номера процессов для взаимодействий.
Компонент с реализацией неблокирующих коллективных операций должен предоставить функцию продвижения выполнения коллективных операций (progress). Эта функция вызывается при каждом обращении к MPI_Test или внутри цикла MPI_Wait. Основные задачи функции progress: запустить на выполнение операции, для которых удовлетворены зависимости по данным, проверить состояние запущенных элементарных операций Send, Recv, Reduce и выполнить их продвижение, например, функцией MPI_Test. Очевидно, что блокирующие коллективные операции можно реализовать на базе неблокирующих. Но по состоянию на момент написания книги в библиотеках Open MPI, MPICH, MVAPICH наиболее развитыми, по количеству алгоритмов, являются подсистемы с блокирующими коллективными операциями.
2.7.3. Коллективные операции с постоянными значениями аргументов
Во многих параллельных приложениях распространен шаблон многократного вызова в цикле коллективной операции. При этом значения аргументов операции не меняются от вызова к вызову. Чтобы сократить накладные расходы на предварительный анализ и обработку аргументов, анализ коммуникатора, построение расписаний, обработку типов данных, в стандарте MPI 4.0 ввели коллективные операции с постоянными значениями аргументов (persistent collective operations) [41] . При первом вызове init-функции выполняется разбор аргументов операции, а запуск обменов выполняется функцией MPI_Start.
MPI_Bcast_init(buf, count, datatype, root, comm, info, request)
while (cond) {
    // Вычисления
    MPI_Start(request)  // запуск Bcast
}
MPI_Request_free(request)
2.7.4. Коллективные операции для виртуальных топологий процессов
В MPI 3.0 добавлены коллективные обмены с соседними процессами в заданной виртуальной топологии (neighborhood collectives) или, как их ещё называют, разреженные коллективные операции (sparse collectives) [42] . До стандарта MPI 3.0 для обмена с соседними процессами (halo-exchange), например в двумерной сетке процессов, использовались двусторонние обмены: вызовы Send/Recv для четырех направлений или операция Alltoallv, в которой только соседние процессы имеют отличные от нуля значения в массиве \(sendcounts[p\)]. Разреженные коллективные операции позволяют указывать буфер отправки и массивы
с числом элементов равным количеству соседних процессов, а размеру \(p\) исходного коммуникатора. Это сокращает накладные расходы на обработку таких массивов и делает возможным дополнительные оптимизации, связанные с отображением виртуальной топологии процессов на физическую топологию коммуникационной сети. Ниже приведен схематичный пример.
// Коммуникатор: двумерная сетка процессов
MPI_Cart_create(MPI_COMM_WORLD, 2, dims, periodic, 0, cartcomm)
// Типы и размеры сообщений соседям: left, right, top, bottom
counts[4] = {1, 1, 1, 1}
types[4] = {col, col, row, row}
sdispls[4] = {DISP(1, 1), DISP(1, nx), DISP(1, 1), DISP(ny, 1)}
rdispls[4] = {DISP(1, 0), DISP(1, nx + 1),
              DISP(0, 1), DISP(ny + 1, 1)}
while (cond) {
  // Вычисления grid[][]

  // Обмен с соседями в двумерной сетке процессов
  MPI_Neighbor_alltoallw(grid, counts, sdispls, types,
                          grid, counts, rdispls, types, cartcomm)
}
Формируется новый коммуникатор cartcomm с декартовой топологией (двумерная сетка процессов). На каждой итерации цикла выполняется обмен граничными значениями вдоль четырёх измерений – по сетке процессов влево, вправо, вверх и вниз. Подразумевается, что сформированы производные типы данных для передачи столбцов col и строк row матрицы, вычислительной сетки.
2.8. Модели параллельных вычислений
Разработка и анализ параллельных алгоритмов основываются на использовании моделей параллельных вычислений (model of parallel computation) – математических моделей, описывающих:
1) архитектуру вычислительной системы;
2) набор базовых операций управления параллельными процессами;
3) методы оценки издержек на организацию параллельных вычислений.
Как правило, в модели фиксируется минимальный набор архитектурных свойств системы и примитивов управления параллельными процессами, достаточный для решения задач, на которые она ориентированна. Описание архитектуры включает описание ее основных вычислительных ресурсов и алгоритмов работы отдельных подсистем. Например, методы маршрутизации пакетов в коммуникационной сети, алгоритмы функционирования разделяемой памяти вычислительных узлов, политики управления кеш-памятью процессоров и обеспечения их когерентности.
Можно выделить две основные цели создания и применения моделей параллельных вычислений.
1. Теоретическая оценка эффективности параллельных алгоритмов. В обозначениях модели строятся аналитические оценки потребления параллельными алгоритмами ресурсов системы, например, издержек на обмены сообщениями, выполнения вычислительных операций, потребления памяти, электроэнергии и пр. Это обеспечивает возможность сравнивать эффективность алгоритмов по некоторым показателям в отрыве от реальных входных данных алгоритма и конфигурации системы [43],[44],[45],[46],[47] .
2. Предсказательное моделирование. Некоторые модели позволяют достаточно точно в аналитическом виде выразить потребление параллельным алгоритмом определенного вида ресурсов системы и использовать полученные оценки для предсказания количественных издержек для конкретной системы, включая перспективные системы [48],[49],[50],[51],[52],[53],[54],[55] . Здесь возникает сопутствующая задача – корректного и эффективного измерения, оценивания значений параметров моделей для конкретных аппаратных реализаций [56],[47] .
Среди известных распространение получили следующие модели параллельных вычислений: PRAM – Parallel Random Access Memory, BSP – Bulk-Synchronous Parallel, модель Р. Хокни и семейство моделей LogP (LogGP, PLogP, LogGPS, LogPC, LogfP).
Модель PRAM (Parallel Random Access Memory) – это абстракция многопроцессорной системы с общей памятью. Издержки на синхронизацию процессоров не учитываются, они взаимодействуют через разделяемую память. В зависимости от допустимых комбинаций одновременного выполнения операций чтения и записи одной ячейки памяти, выделяют следующие варианты модели:
-
EREW-PRAM – только один процессор может одновременно читать и записывать данные в определенную ячейку памяти (exclusive read, exclusive write);
-
CREW-PRAM – несколько процессоров могут одновременно читать ячейку памяти, записывать – только один (concurrent read);
-
ERCW-PRAM – несколько процессоров могут одновременно записывать в ячейку памяти, читать – только один (concurrent write);
-
CRCW-PRAM – одну ячейку памяти можно параллельно читать и перезаписывать (concurrent read, concurrent write).
Эта модель нашла применение при анализе параллельных алгоритмов, в частности многопоточных программ (например, разработанных с использованием языков Cilk/Cilk++ и стандарта OpenMP).
Модель BSP (Bulk-Synchronous Parallel) – модель вычислительной системы с распределенной памятью. Каждый из \(p\) процессоров имеет локальную память [44] . Процессоры реализуют взаимодействия по средствам односторонних обменов сообщениями (put, get). Параллельный алгоритм представляется как последовательность супершагов (superstep), на каждом из которых процессоры выполняют локальные вычисления, обмены сообщениями и барьерную синхронизацию (рис. 1.1).
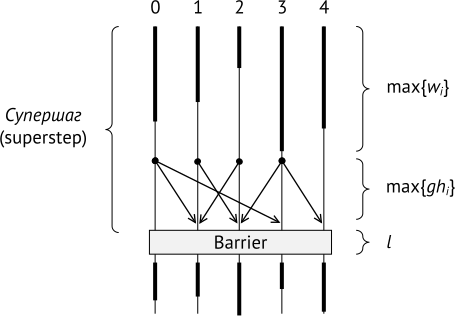
Модель позволяет выразить суммарное время выполнения всех обменов процессорами на фиксированном супершаге. Параметры модели: \(p\) – число процессоров (процессов), \(g\) – время передачи по сети одного байта, \(l\) – время выполнения барьерной синхронизации. Время выполнения супершага выражается как:
где \(w_i\) – время локальных вычислений процессора \(i \in \{1,2,\ldots,p\}\), \(h_i\) – суммарный размер сообщений передаваемых или принимаемых процессором \(i\) на супершаге. Заметим, что в рамках модели BSP передача одного сообщения размером 100 байт занимает столько же времени, сколько и передача 100 сообщений размером один байт.
Основной механизм взаимодействия параллельных процессов в системах с распределенной памятью – двусторонние обмены сообщениями по каналам связи (point-to-point communications). Для оценки времени выполнения таких операций разработано значительное количество аналитических коммуникационных моделей. Среди них наибольшее распространение получили модели Р. Хокни (R. Hockney) и семейство моделей LogP (LogGP, PLogP, LogGPS, LogPC, LogfP).
2.8.1. Модель вычислительной системы
Для оценки времени выполнения коммуникационных алгоритмов мы будем использовать простую модель вычислительной системы, в которой время передачи сообщения длиной \(m\) байт от одного процесса другому занимает \(\alpha + m\beta\) единиц времени. Параметры модели: \(\alpha\) – задержка при передаче сообщения (латентность, latency, startup time), \(\beta\) – время, требуемое для передачи одного байта сообщения. Допущения модели и соглашения:
-
время затрачиваемое на передачу сообщения равно времени на его прием (равнозначность операций Send и Recv);
-
на каждом вычислительном узле имеется сетевой интерфейс с одним портом (1-port model);
-
сетевой интерфейс позволяет выполнять одновременную передачу одного сообщения и приём другого (full duplex);
-
каждый из \(p\) процессов может передавать и принимать сообщения от любого другого (топология системы и маршрутизация игнорируются).
При необходимости в модель вводятся два дополнительных параметра: \(\lambda\) – время копирования из памяти в память одного байта (характеристика подсистемы памяти узла), \(\gamma\) – время выполнения операции локальной редукции для одного байта (характеристика процессорного ядра).
2.8.2. Модель Хокни
Модель Хокни (R. Hockney) – одна из простейших линейных моделей, описывающая вычислительную систему двумя параметрами \(\alpha\) и \(\beta\) [43],[26],[27],[57] . Время \(t(m)\) передачи сообщения размером \(m\) байт между двумя процессами/процессорами выражается как
где \(\alpha\) – задержка при передаче сообщения (латентность, latency, startup time), \(\beta\) – время, требуемое для передачи одного байта сообщения.
В оригинальной работе Р. Хокни [43] используются иные обозначения. Выражение для времени \(t\) передачи сообщения размером \(m\) байт имеет вид:
где \(t_0\) – время передачи сообщения нулевой длины (латентность сети), \(r_{\infty}\) – асимптотическая пропускная способность канала связи (asymptotic bandwidth, максимальная пропускная способность канала связи при передаче сообщения бесконечного размера). В модели также фигурируют параметры \(m_{1/2}\) – размер сообщения, на котором достигается половина асимптотической пропускной способности канала связи (half-peak length), и \(\pi_0\) – пропускная способность для коротких сообщений. Значения параметров связаны следующим отношением:
Данная модель получила широкое распространение. Созданы ее вариации, в которых параметры \(\alpha\) и \(\beta\) представлены в виде функций от размера \(m\) сообщения и/или числа процессоров в вычислительной системе, предложены различные подходы к учету одновременного разделения каналов связи несколькими процессорами.
К недостаткам модели можно отнести то, что параметр \(\alpha\) включает в себя как латентность канала связи, так и накладные расходы процессора на передачу/прием сообщения (например, упаковка сообщения в структуры данных протокола MPI, инициализация канала связи).
Величина \(1/\beta\) отражает пропускную способность канала связи (bandwidth). Как правило, за ее значение принимается верхняя граница пропускной способности для конкретной коммуникационной технологии (например, Gigabit Ethernet, InfiniBand EDR).
На рис. 1.2 показана иллюстрация модели Хокни. Процесс 0 три раза передает сообщение размером \(m\) байт процессу 1. Процесс 1 получает первый байт первого сообщения через \(\alpha\) единиц времени и принимает все сообщение за время \(m\beta\). Процесс 0 не может начать передачу очередного сообщения до тех пор, пока процесс 1 не получил предыдущее. Поэтому второе сообщение процесс 0 начинает передавать в момент времени \(\alpha + m\beta\), а процесс 1 получает его в момент времени \(2(\alpha + m\beta)\). Оба процесса заканчивают обмены за время \(3(\alpha + m\beta)\).
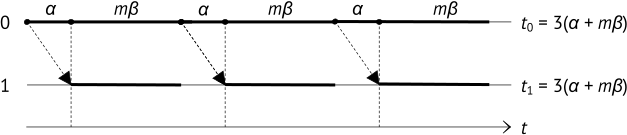
Модель максимально абстрагируется от архитектуры вычислительной системы и деталей реализации инструментария параллельного программирования (игнорируется многопоточность, присутствие неблокирующих коммуникационных операций). Предполагается, что латентность \(\alpha\) и пропускная способность \(1/\beta\) не зависят от размера \(m\) передаваемого сообщения. Считается, что каналы связи допускают двусторонний обмен данными (bidirectional channels). В любой момент времени процесс может принимать либо передавать сообщение одному процессу. Время передачи сообщения не зависит от структуры коммуникационной сети, протоколов маршрутизации и числа взаимодействующих процессов (все каналы связи имеют одинаковую производительность, их перегрузка невозможна, сетевые конфликты/коллизии не возникают). Вычислительные узлы системы однородны, их процессоры имеют одинаковую производительность.
Другим значительным ограничением модели является то, что она не позволяет моделировать совмещение обменов с вычислениями и конвейерную передачу сообщений в сети [48] . Например, на рис. 1.2 после отправки первого сообщения процесс 0 начинает передачу второго только в момент времени \(\alpha + m\beta\). Однако на практике передача второго сообщения может быть начата раньше.
Коммуникационные операции систем параллельного программирования могут включать не только сетевые операции. Поэтому модель расширяют дополнительными параметрами. Производительность процессоров и накладные расходы на выполнение бинарной операции редукции могут быть отражены в модели в виде параметра \(\gamma\) – времени выполнения процессом бинарной операции редукции для одного байта сообщения. Общее время выполнения локальной редукции для сообщения размером \(m\) байт выражается как \(m\gamma.\) В большинстве работ полагают, что значение параметра \(\gamma\) не зависит от вида бинарной операции (сложение, умножение, заданная пользователем операция) и типа данных операндов (элементов сообщения: целый, вещественный и др.).
Учитывая разрыв в производительности коммуникационных сетей, процессоров и подсистем оперативной памяти, можно считать справедливыми следующие неравенства:
В некоторых алгоритмах целесообразно учитывать время копирования сообщений из одного буфера в оперативной памяти в другой. Для этого можно использовать параметр \(\lambda\) – время передачи одного байта между двумя буферами в оперативной памяти. Тогда время копирования сообщения размером \(m\) байт из буфера в буфера есть \(m\lambda\).
2.8.3. Модель LogP
Модель LogP [45] – это линейная модель вычислительной системы с распределенной памятью, в которой параллельные процессы взаимодействуют посредством двусторонних обменов короткими сообщениями фиксированного размера. Модель игнорирует структуру коммуникационной сети и отражает лишь показатели производительности каналов связи между процессорами. Заметим, что модель не потеряет своей общности, если вместо процессоров речь будет идти о процессах параллельной программы.
Основные параметры модели:
-
\(L\): верхняя граница латентности (latency, delay) передачи сообщения одного процессора другому;
-
\(o\): промежуток времени (overhead), в течение которого процессор занят передачей или приемом сообщения (в течение этого времени процессор не может выполнять другие операции);
-
\(g\): минимальный интервал времени (gap) между последовательными передачами или приемами сообщений (\(1/g\) – пропускная способность канала, связи доступная процессору);
-
\(P\): количество процессоров в системе.
Параметры \(L,o\) и \(g\) измеряются в тактах работы процессора, но без труда могут быть выражены в секундах. Неявным параметром модели является размер \(w\) сообщения. Предполагается, что сообщения имеют небольшой размер, одно или несколько машинных слов.
Время передачи сообщения от одного процессора другому выражается как
На рис. 1.3 показан пример последовательной передачи процессором 0 трех сообщений процессору 1. В нулевой момент времени процессор 0 инициирует передачу сообщения процессору 1. Для этого ему требуется \(o\) единиц времени на выдачу сообщения в сеть, далее, через \(L\) единиц времени сообщение достигает процессора 1. Процессор 1 затрачивает \(o\) единиц времени для получения сообщения из сети. Далее процессор 0 отправляет второе сообщение. Он не может начать передачу менее, чем через \(\max\{o, g\}\) единиц времени с момента начала передачи первого сообщения. В приведенном примере предполагается, что \(g > o\). Таким образом, вторая и третья передачи сообщений процессором 0 начинаются в моменты времени \(g\) и \(2g\) соответственно. Процессор 0 завершает работу в момент времени \(2g + o\), а процессор 1 завершает прием данных за время \(L + 2g + 2o\).
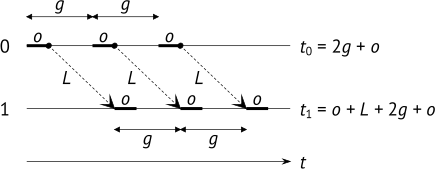
Перед оценкой времени выполнения, как правило, фиксируют отношения между значениями \(L, o\) и \(g\). Например, полагают, что имеют место неравенства
Модель основана на ряде допущений. Подразумевается, что коммуникационная сеть имеет конечную емкость (finite capacity). Это означает, что в ней одновременно может находиться не более \(\left\lceil L/g \right\rceil\) сообщений, передаваемых или принимаемых одним процессом.
Все процессоры функционируют асинхронно и, как следствие, латентность передачи сообщений может варьироваться вплоть до значения \(L\). Недетерминированный характер латентности может привести к тому, что сообщения, предназначенные для одного процессора могут быть доставлены в порядке, отличном от исходного.
На практике некоторые параметры модели могут быть опущены. В частности, если процессоры относительно редко обмениваются сообщениями, то пропускную способность \(1/g\) сети и ограничения на ее емкость можно игнорировать. В то же время, в некоторых системах накладные расходы \(o\) могут превышать значение \(g\), что позволяет не учитывать последний параметр.
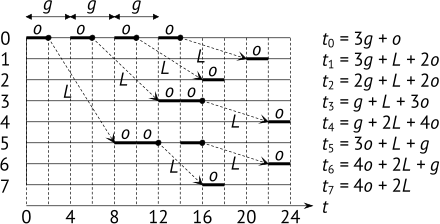
На рис. 1.4 приведен пример оптимального, в модели LogP, дерева широковещательной рассылки (optimal broadcast tree) для 8 процессоров [45] , а на рис. 1.5 – пространственно-временная диаграмма выполнения обменов между ними. Предполагается, что \(g \ge o\). Процессор 0 выполняет передачи сообщений в моменты времени 0, \(g, 2g\) и \(3g\). Он завершает все передачи в момент времени \(3g + o\). Наибольшее время выполнения имеют процессы 4 и 6. Время их работы равно \(g + 2L + 4o\).
Передачу длинного сообщения в модели LogP можно представить как серию передач коротких фрагментов длины \(w\) байт. Исходное сообщение размером \(m\) байт разбивается на \(\left\lceil m / w \right\rceil\) коротких сообщений, которые последовательно передаются получателю. На это требуется
единиц времени. Такой подход имеет свои недостатки – передача следующего фрагмента сообщения начинается через \(g\) единиц времени. Последнее не всегда справедливо для реальных ВС, которые, как правило, обладают специальными средствами передачи сообщений больших размеров.
Важным отличием модели LogP от модели Хокни является возможность моделирования совмещения во времени передачи сообщений разными процессорами. Например, на рис. 1.5 процессор 0 отправил сообщение процессору 1, процессор 1 не успел его принять, а процессор 0 уже начал передачу сообщения процессору 3.
2.8.4. Модель LogGP
Многие распределенные вычислительные системы имеют специальные возможности для эффективной передачи сообщений большого размера. Например, имеют в своем составе специальную коммуникационную сеть или используют оптимизированные коммуникационные протоколы для сообщений большого размера. В работе [46] предложена модель LogGP – расширение линейной модели LogP для сообщений большого размера. Она применима как для коротких, так и для длинных сообщений.
Параметры модели:
-
\(L\): верхняя граница латентности (latency, delay) передачи сообщения одного процессора другому;
-
\(o\): промежуток времени (overhead), в течение которого процессор занят передачей или приемом сообщения (в течение этого времени процессор не может выполнять другие операции);
-
\(g\): минимальный интервал времени (gap) между последовательными передачами или приемами короткого сообщения (\(1/g\) –пропускная способность канала связи для коротких сообщений);
-
\(G\): минимальный интервал времени между последовательными передачами или приемами одного байта длинного сообщения (gap per byte, \(1/G\) – пропускная способность канала связи для длинных сообщений);
-
\(P\): количество процессоров в системе.
Иллюстрацией к модели LogGP служит рис. 1.6, на котором показана пространственно-временная диаграмма последовательной передачи процессором 0 трех длинных сообщений процессору 1. В момент времени \(o\) процессор 0 завершил передачу в сеть первого байта сообщения, в момент времени \(o + G\) в сеть передан второй байт сообщения. Последний байт первого сообщения будет отправлен в сеть в момент времени \(o + (m - 1)G\). Для доставки каждого байта сообщения от процессора 0 до процессора 1 требуется \(L\) единиц времени. Первый байт сообщения процессор 1 получает из сети в момент времени \(o + L\). Прием всего сообщения процессором 1 завершается в момент времени \(o + L + (m - 1)G + o\).
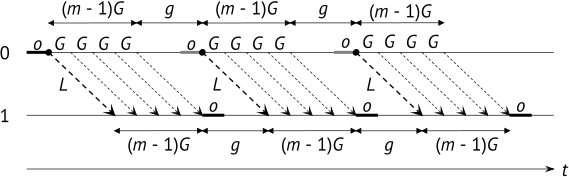
Как видно из рис. 1.6, если процессор выполняет последовательно две передачи (или приема) сообщения, то отправка в сеть первого байта второго сообщения выполняется не ранее чем через \(g\) единиц времени с момент передачи в сеть последнего байта первого сообщения. Отметим, что в этом модель LogGP отличается от модели LogP. В модели LogP повторная передача (прием) выполняется не ранее чем через \(g\) единиц времени с момента начала процедуры передачи сообщения, которая включает интервал \(o\) (рис. 1.6).
Как и в модели LogP, некоторые параметры модели LogGP могут быть опущены. Так, если в системе моделируется передача очень больших сообщений, то время выполнения сетевых операций можно положить равным \(mG\), где \(m\) – размер сообщения.
Полезно отметить, что практическое использование модели LogGP для анализа алгоритмов имеет смысл, если последние в явном виде оперируют большими сообщениями. Например, группируют короткие сообщения для получения преимуществ от большей пропускной способности каналов связи.
3. Широковещательная передача
В стандарте MPI определено два типа операций широковещательной рассылки сообщений из выделенного корневого процесса (root) всем членам коммуникатора: Bcast и Scatter. В операции Bcast корень передает всем одно и то же сообщение, содержимое одного буфера. В случае Scatter корневой процесс рассылает всем персональные сообщения. Для Scatter также определена операция Scatterv, поддерживающая рассылку сообщений разных размеров.
3.1. Операция Bcast
В операции Bcast корневой процесс \(root\) передает \(count\) элементов типа \(datatype\) всем процессам коммуникатора \(comm\).
MPI_Bcast(buf, count, datatype, root, comm)В корневом процессе \(buf\) выступает в качестве буфера отправки, а в некорневых процессах – буфером для приема сообщения. Всем процессам рассылается одинаковое сообщение, поэтом данную операцию также называют неперсонифицированной широковещательной передачей (non-personalized broadcast). В отечественной литературе закрепилось альтернативное название – трансляционный обмен [58],[2],[3],[4] .
где \(m = count \cdot \mathrm{sizeof}(datatype).\)
Рассмотрим основные алгоритмы реализации операции Bcast. Мы будем двигаться от простейших к более сложным и эффективным. Нас будут интересовать только алгоритмы, которые в явном виде используют операции Send/Recv для выполнения отдельных шагов коллективной операции. Мы осознано не будем рассматривать аппаратно реализованные алгоритмы (например, NVIDIA SHARP, Cray Aries Collective Engine), так как они эксплуатируют аналогичные идеи. Также мы не будем рассматривать алгоритмы для фиксированных сетевых топологий (\(k\)D-торов, многомерных кубов, многокаскадных сетей) и иерархические методы, которые в пределах многопроцессорного узла локализуют обмены между процессами через его общую память. Все перечисленные специальные методы в своей основе опираются на базовые алгоритмы, которые и являются предметом нашего рассмотрения.
Значительная часть известных алгоритмов основана на логической организации процессов в деревья различных видов. Зная свой номер \(rank\) каждый процесс определяет номера процессов с которыми он выполняет коммуникации. В подавляющем большинстве случаев такие вычисления выполняется за константное время относительно \(p\). Мы будем отдельно обсуждать ситуации когда время вычисления положения процесса в дереве функционально зависит от \(p\). При анализе времени выполнения алгоритмов будем подсчитывать затраты на выполнение операций Send и Recv.
3.2. Алгоритмы с линейной сложность
Классическими представителями алгоритмов с линейной зависимостью времени выполнения от числа процессов являются линейный алгоритм (linear broadcast, flat tree broadcast), конвейерный алгоритм (pipeline, chain) и их комбинация – алгоритм параллельных цепочек (\(k\)-chain broadcast).
В линейном алгоритме корневой процесс \(root\) последовательно передает сообщение \(p - 1\) процессам. Ниже приведен его псевдокод. Считаем, что операции Send и Recv блокируют выполнение алгоритма до завершения передачи и приема сообщения.
algorithm BcastLinear(buf, count, type, root)
  if rank = root then
    for (i = 0; i < p; i++)
      if i != root then
        Send(buf, count, type, i)
    end for
  else
    Recv(buf, count, type, root)
  end if
end algorithm
На рис. 3.1 показана временная диаграмма выполнения алгоритма для четырёх процессов.
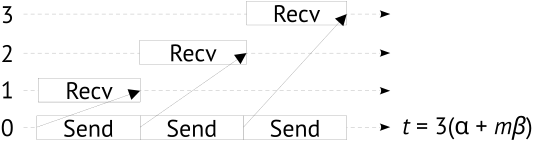
Корневой процесс 0 выполняет последовательную передачу трех сообщений. Каждая передача длится \(\alpha + m\beta\) единиц времени. Прямоугольники с операциями отражают время на коммуникации, в них не включено время ожидания поступления сообщения. Например, процесс 2 ожидает в операции Recv начала приема \(\alpha + m\beta\) единиц времени, пока корень не завершит передачу сообщения процессу 1. Аналогично, в процессе 3 время ожидания составляет \(2(\alpha + m\beta)\). Время выполнения алгоритма определяется наибольшим из времен выполнения процессов, которое приходится на корневой процесс и процесс с номером \(p - 1\). В общем случае время выполнения линейного алгоритма
В конвейерном алгоритме Bcast процессы по цепочке, начинаю с корневого, передают друг другу сообщение. Ниже приведен псевдокод алгоритма, в котором учитывается возможность назначения корневым любого процесса.
algorithm BcastPipeline(buf, count, type, root)
  next = (rank + 1) % p
  if rank = root then            // Первый процесс в цепочке
    Send(buf, count, type, next)
  else
    prev = (rank - 1 + p) % p
    Recv(buf, count, type, prev)
    if next != root then
      Send(buf, count, type, next)
  end if
end algorithm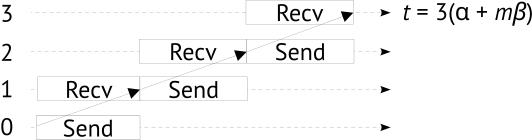
На рис. 3.2 приведен пример для четырёх процессов. Первым выполнение завершает корневой процесс, а последним – процесс \((root - 1 + p) \mathbin{\%} p\) в конце цепочки, время которого и определяет итоговое время алгоритма
Зададимся вопросом – как можно сократить время выполнения линейных алгоритмов, как построить более быстрый алгоритм Bcast? Очевидная идея – реализовать одновременную передачу сообщений в нескольких цепочках процессов.
3.3. Алгоритм параллельных цепочек
Алгоритм параллельных цепочек (\(k\)-chain) организует \(p\) процессов в \(k\) цепочек, где \(k\) – это входной параметр алгоритма. На первом шаге корень передает сообщение лидеру первой цепочки, на втором шаге корень передает сообщение лидеру второй цепочки и одновременно с этим лидер первой цепочки передает сообщение своему следующем процессу.
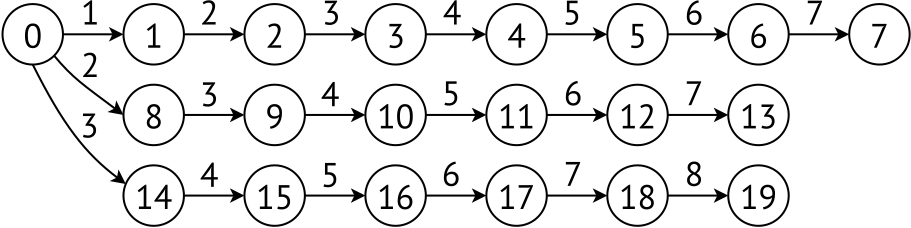
После шага \(k\) лидеры всех цепочек получили сообщение от корня и по всем цепочкам выполняется параллельная передача сообщений – это ключевая идея алгоритма. В каждую цепочку входит по \((p-1)/k\) процессов. Если \(p-1\) не делится без остатка на \(k\), то остаток отделения, \((p-1) \mathbin{\%} k\) процессов, распределяются по первым \((p-1) \mathbin{\%} k\) цепочкам – в каждую добавляется по одному процессу. Отметим, что добавлять процессы из остатка целесообразно в первые цепочки, так как это приводит к меньшему увеличению времени выполнения алгоритма по сравнению с добавлением в последние цепочки. Предлагаем читателю самостоятельно проверить это утверждение.
На рис. 3.3 приведен пример для \(p=20\) процессов, которые организованы в \(k=3\) параллельные цепочки по 6 процессов. В первую цепочку включен дополнительный процесс из остатка от деления 19 на 3. Числа над дугами – это номер шага, на котором выполняется передача. Например, процесс 7 получит сообщение в момент времени \(7(\alpha+m\beta)\), а процесс 19 в \(8(\alpha+m\beta)\). Время выполнения алгоритма определяется временем завершения \((p-1)/k - 1\) передач в последней цепочке:
Нетрудно заметить, что время выполнения алгоритма параллельных цепочек линейно зависит от числа процессов, как и в предыдущих алгоритмах. Открытым остается вопрос о выборе значения \(k\). На практике для заданной вычислительной системы можно экспериментально определить оптимальные значения \(k\) для различных \(p\) и \(m\). Рассмотрим альтернативный подход, который лежит в основе следующего алгоритма, – это теоретическое нахождение оптимального числа цепочек (в рамках нашей модели \(m\), \(p\), \(\alpha\), \(\beta\)).
Для построения алгоритма с оптимальным числом параллельных цепочек (\(k\)-opt-chain) из полученного выражения \(t_{{k-chain}}\) найдем число \(k\) цепочек, при котором он работает за минимальное время. Для этого найдем производную функции по \(k\) и приравняем её к нулю
Отсюда оптимальное число цепочек \(k^{*} = \sqrt{p-1}\). Подставим полученное значение \(k^{*}\) в выражение для времени \(t_{{k-chain}}\) и получим время работы алгоритма с оптимальным числом цепочек:
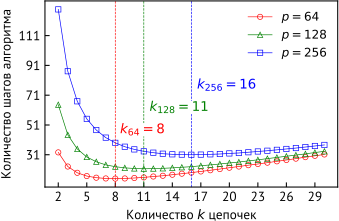
Этот алгоритм имеет степенную зависимость времени работы от числа процессов (показатель степенной функции \(\frac{1}{2}\)). Время выполнения с увеличением \(p\) растет медленнее чем у алгоритмов с линейным числом шагов. На рис. 3.4 показана зависимость количества шагов алгоритма (операций передачи), от числа \(k\) цепочек для 64, 128 и 256 процессов. На кривых показаны значения \(k_{64}\), \(k_{128}\) и \(k_{256}\), при которых достигается минимум времени выполнения алгоритма для соответствующего числа процессов.
Разовьем идею алгоритма параллельных цепочек – построим алгоритм с цепочками уменьшающейся длины.
3.4. Алгоритм параллельных цепочек переменной длины
На рис. 3.5 показан пример 11 процессов и трёх цепочек, это оптимальное количество цепочек для такого числа процессов.
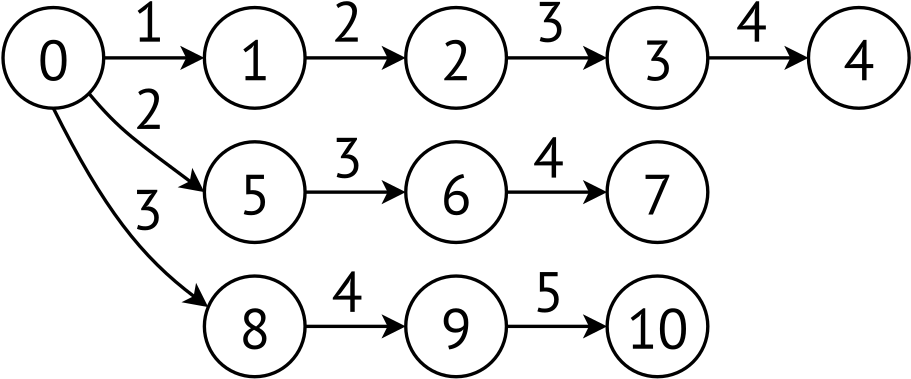
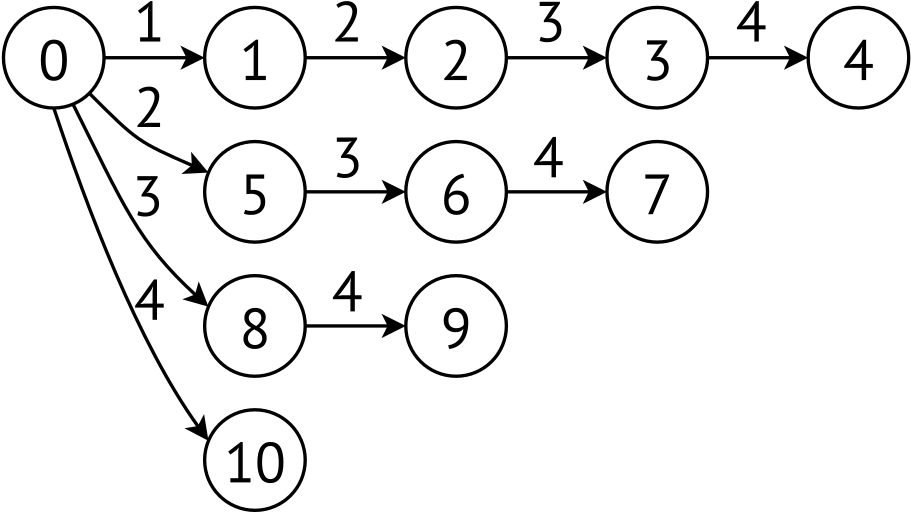
Алгоритм завершается за 5 шагов. Нетрудно заметить, что передача сообщения в следующей цепочке завершается на один шаг позже текущей или за такое же время. Это связано с тем, что на доставку сообщения в очередную цепочку корневому процессу требуется отдельный шаг. Чтобы время завершения операций в цепочках не превышало времени первой, каждая следующая цепочка должна быть на один процесс короче предыдущей. Эта базовая идея алгоритма параллельных цепочек переменной длины. Длины цепочек образуют убывающую арифметическую прогрессию. В первой цепочке \(k\) процессов. На рис. 3.6 приведен пример для 11 процессов с \(k=4\) цепочками длин 4, 3, 2, 1. Итоговое время выполнения алгоритма – 4 шага, что быстрее алгоритма с тремя параллельными цепочками (рис. 3.5).
Найдем для заданного числа \(p\) процессов число \(k\) цепочек переменной длины. По цепочкам распределены \(p-1\) процессов: \(k\) процессов в первой цепочке, \(k-2\) – во второй, \(\ldots\), в последней – один процесс. Из выражения для суммы \(n\) элементов арифметической прогрессии получаем равенство:
Откуда находим значение \(k\):
Если \(p-1\) не делится без остатка на \(k\), то остаток отделения, \((p-1) \mathbin{\%} k\) процессов, распределяются по первым \((p-1) \mathbin{\%} k\) цепочкам – в каждую добавляется по одному процессу. Время выполнения алгоритма определяется временем цепочки \(k\):
Этот алгоритм имеет степенную зависимость времени работы от числа процессов, как и алгоритм с оптимальным числом параллельных цепочек. На рис. 3.7 показана зависимость времени выполнения алгоритмов от числа процессов, а также нижняя граница \(\log_2p\) числа шагов операции Bcast.
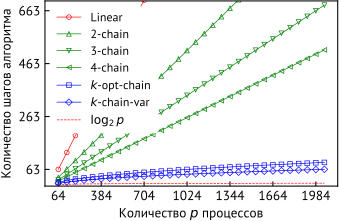
Перейдем к рассмотрению алгоритмов, которые выполняют операцию Bcast за логарифмическое число шагов от числа процессов.
3.5. Алгоритм бинарного дерева
Алгоритм выстраивает процессы в бинарное дерево (binary tree), по которому от корня к листам передается сообщение. Ключевая идея алгоритма – параллельная передача данных в левом и правом поддеревьях корня. Каждый процесс вычисляет свое положение в дереве, номер \(parent\) родительского процесса и номера дочерних \(left\), \(right\), только на основе своего номера \(rank\) и общего числа \(p\) процессов. Конкретный алгоритм вычисления \(parent\), \(left\), \(right\) определяется формой бинарного дерева и способом нумерации узлов – распределением \(p\) процессов по дереву. На практике распространение получили две формы деревьев для операции Bcast: завершенное бинарное дерево (complete binary tree) и бинарное дерево сбалансированное по число узлов в поддеревьях. Ниже мы рассмотрим их по отдельности.
Нумерацию узлов дерева можно задать разными способами. Эта процедура должна быть нетрудоёмкой и позволять каждому процессу вычислять свое положение за разумное для практики время – желательно за константное время, которое не зависит от числа процессов. Можно выделить следующие способы нумерации узлов:
-
в порядке прямого обхода дерева (pre-order);
-
в порядке симметричного обхода (in-order);
-
в порядке обратного обхода (post-order);
-
позиция каждого процесса явным образом вычисляется из его номера \(rank\).
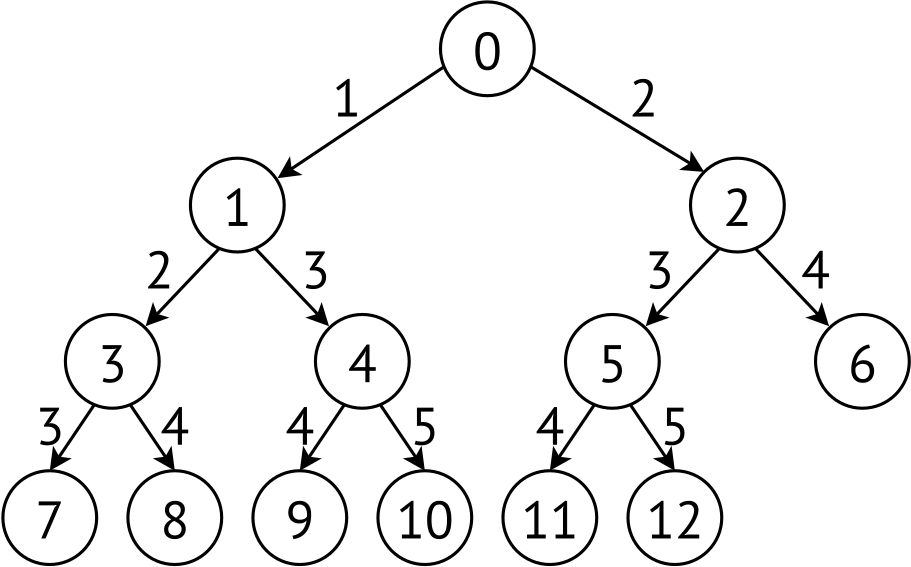
Завершенное бинарное дерево (complete binary tree) – бинарное дерево, в котором все уровни заполнены, возможно за исключением последнего, который заполняется слева направо. Зная свой номер \(rank\) каждый процесс за константное время вычисляет номера родительского узла \(parent\), левого \(left\) и правого \(right\) дочерних процессов, если они присутствуют:
На рис. 3.8.а приведен пример завершенного бинарного дерева для \(p=13\) процессов. Последним сообщение получает самый правый листовой процесс 12 на шаге 5. В этом примере самый левый лист имеет высоту больше чем самый правый, поэтому такое дерево будем называть левосторонним деревом.
Для операции Bcast используют левосторонние деревья. Потому, что корневому процессу целесообразно на первом шаге передавать сообщение в поддерево с большим числом узлов. Это обеспечит завершение операции Bcast во втором поддереве за время не превосходящее время в поддереве c большим числом узлов. Например, на рис. 3.8.б показано правостороннее дерево для 13 процессов. Операция Bcast в нем завершается за 6 шагов, что на 1 шаг больше чем в левостороннем дереве.
Как было показано выше, алгоритм заканчивает работу, когда самый правый листовой процесс получает сообщение. Для простоты анализа оценим время выполнения алгоритма завершенного бинарного дерева, для случая когда все листовые узлы находятся на одной высоте, а все не листовые процессы имеют два дочерних узла – форма совершенного бинарного дерева (perfect binary tree). В этом случае время выполнения операции Bcast определяется временем правого листа:
где \(h\) – высота самого правого дочернего листа. Если завершенное дерево имеет форму отличную от совершенной, время выполнения операции Bcast не превосходит \(t_{{BinTree}}\).
Из выражения \(t_{{BinTree}}\) видно, что время выполнения алгоритма бинарного дерева логарифмически зависит от числа процессов. В то же время, оно в два раза больше нижней границы времени Bcast по латентности (константа перед \(\alpha\)) и в \(2\log_2 p\) раз больше нижней границы по пропускной способности (константа перед \(\beta\)).
Нетрудно обобщить алгоритм путем перехода к алгоритму \(k\)-ичного завершенного дерева (\(k\)-ary complete tree), в котором каждый узел имеет не более \(k\) дочерних процессов. Время выполнения такого алгоритма будет определяться временем самого правого листа (рис. 1.9):
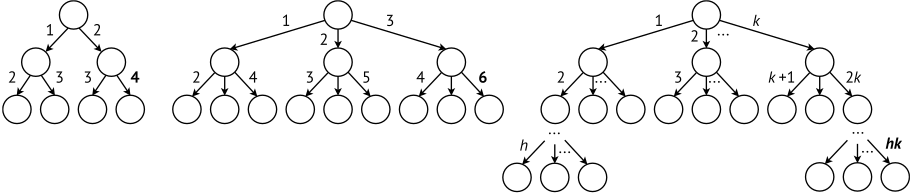
Ниже приведен псевдокод обобщенного алгоритма. Обратим внимание на то, что корнем \(root\) операции может быть выбран любой процесс. В приведенных ранее формулах для вычисления положения процесса в завершенном бинарном дереве предполагается что \(root = 0\). Мы можем ввести новую нумерацию процессов (смещенную, shifted), в которой корень будет иметь номер 0, вычислить положения каждого узла с использованием ранее рассмотренных формул, а при выполнении операции осуществить обратный переход к исходной нумерации. Процесс получает новый номер \(srank = (rank - root + p) \mathbin{\%} p\) циклическим сдвигом. Обратный переход \(rank = (srank + root) \mathbin{\%} p\).
algorithm BcastKTree(buf, count, type, root)
  srank = (rank - root + p) % p  // Переход к root = 0
  for (i = 0; i < k; i++)        // Вычисление дочерних процессов
    child[i] = k * srank + i + 1
  end for
  if rank != root then
    sparent = (srank - 1) / 2    // Лист или внутренний узел
    Recv(buf, count, type, (sparent + root) % p)
  end if
  for (i = 0; i < k; i++)
    if child[i] < p then
      Send(buf, count, type, (child[i] + root) % p)
  end for
end algorithm
Время выполнения алгоритма \(k\)-ичного дерева в \(k\) раз больше нижней границы по латентности и в \(k\log_k p\) раз больше нижней границы по пропускной способности.
Для реализации Bcast можно использовать \(k\)-ичные деревья и других видов. Например, дерево сбалансированное по числу узлов (рис. 1.10). В левом и правом поддеревьях число процессов отличается не более чем на единицу. Время выполнения Bcast завершается за 5 шагов, как и в случае завершенного бинарного дерева. В таком дереве процесс \(rank\) находится на уровне \(l = \lfloor \log_k (rank + 1) \rfloor\), а его дочерние узлы имеют номера:
Вычисление позиции процесса в сбалансированном по числу узлов дереве связно с вычислением логарифмов и возведением в степень, на это может потребоваться порядка \(O(\log p)\) единиц времени. Этот алгоритм реализован в библиотеке Open MPI (компонент coll/base).
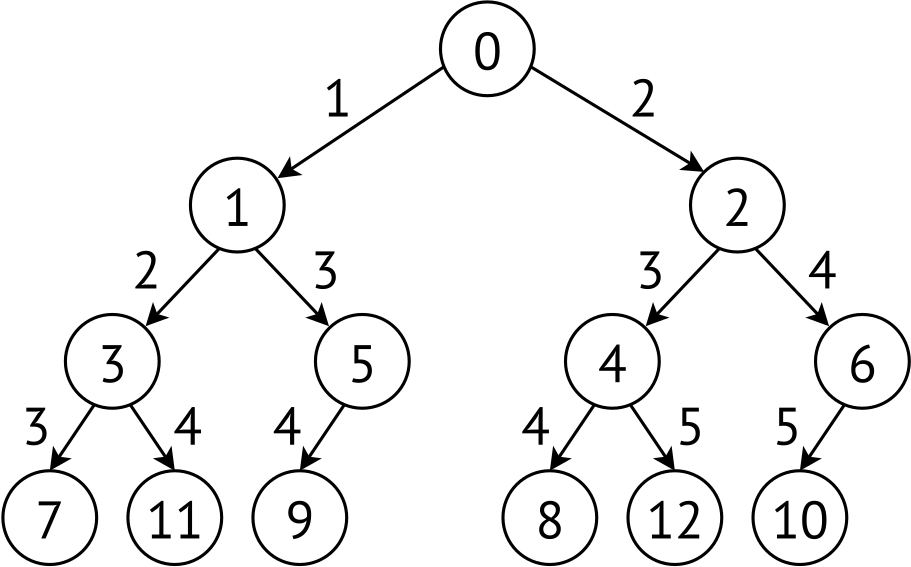
Заметим, что два дерева Bcast с одной формой и разной нумерацией узлов могут приводить как разному времени на целевой системе. Это связано с тем, как процессы распределены по процессорам вычислительной системы (process mapping, task affinity). Например, возможна ситуация, при которой родитель и дочерний узел в дереве размещены на значительном расстоянии в топологии системы, например, на процессорах разных вычислительных узлов. Учет распределения процессов по процессорам системы и топологии сети – это задача архитектурно-ориентированных алгоритмов, рассмотрение которые выходят за тематические рамки этой книги.
Вернемся к вопросу о выборе оптимального значения \(k\) для завершенного бинарного дерева операции Bcast.
3.6. Алгоритм оптимального \(k\)-ичного дерева
Из выражения для \(t_{{KTree}}\) найдем оптимальную \(k^*\) степень дерева, при которой время выполнения операции Bcast минимально.
Таким образом тернарное дерево (\(k = 3\)) является оптимальным в рассматриваемой \(\alpha\)-\(\beta\) модели. На рис. 3.11 показана зависимость количества шагов алгоритма от степени \(k\) дерева для различного числа процессов.
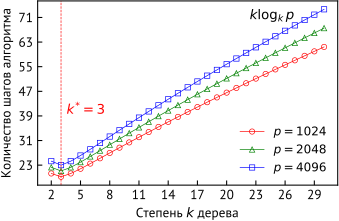
Полученный алгоритм все еще не достигает нижней границы времени выполнения Bcast. Построим более эффективный алгоритм. Обратим внимание на то, что в бинарном дереве степень каждого узла фиксирована, она не зависит от числа потомков. Чтобы время завершения операций в поддеревьях корня не превышало времени в первом поддереве, надо чтобы каждое следующее поддерево было на единицу ниже предыдущего (содержало меньше узлов). Эта идея лежит в основе алгоритма биномиального дерева.
3.7. Алгоритм биномиального дерева
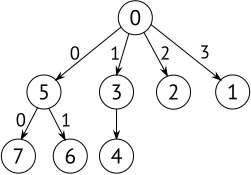
В данном алгоритме процессы выстраиваются в биномиальное дерево. Каждое биномиальное дерево \(B_k\) (binomial tree) порядка \(k\) – это рекурсивно определенное корневое упорядоченное дерево состоящее из двух деревьев \(B_{k-1}\), связанных вместе, так что корень одного является крайним слева дочерним узлом другого. На рис. 3.12 приведены примеры четырех биномиальных деревьев B0, B1, B2 и B3. Количество дочерних узлов вершины логарифмически зависит от числа её потомков. Это принципиально отличает биномиальные деревья от \(k\)-ичных, в которых степень узла фиксирована.
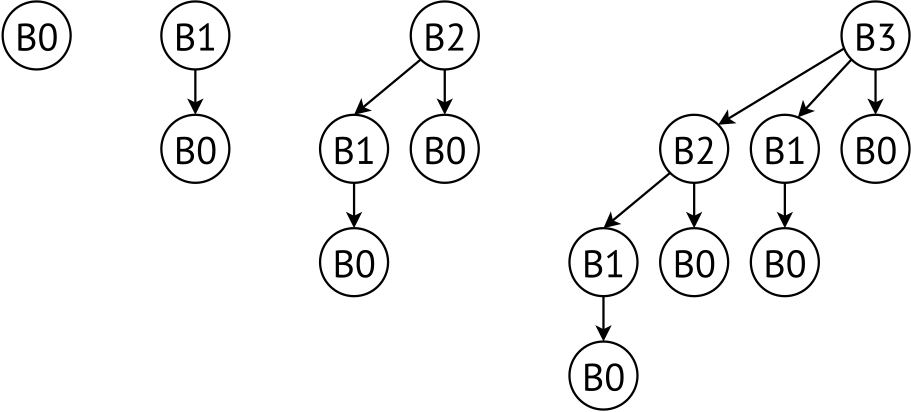
Биномиальное дерево Bcast для \(p\) процессов – это совокупность биномиальных деревьев, степени которых определяются номерами значащих битов в двоичном представлении числа \(p\) процессов, участвующих в операции. Степени всех биномиальных деревьев различны. Например, при числе процессов \(p=8=1000_2\) имеем одно биномиальное дерево \(B_3\) (рис. 3.13).
Обозначим через \(i_1, i_2, \ldots, i_n\) номера значащих битов в двоичном представлении числа \(p\)
Все биномиальные деревья объединены в единое дерево обменов, корнем которого является корень биномиального дерева \(B_{i_n}\) – дерево наибольшей степени:
-
самым левым дочерним узлом корня \(B_{i_n}\) является корень дерева \(B_{i_{n-1}}\);
-
самым левым дочерним узлом \(B_{i_{n-1}}\) является корень дерева \(B_{i_{n-2}}\);
-
\(\ldots\)
-
самым левым дочерним узлом корня \(B_{i_2}\) является корень дерева \(B_{i_1}\).
На рис. 3.13 показано дерево обменов для \(p = 13=1101_2\) процессов. Корнем всего дерева является дерево \(B_3\), его самым левым дочерним узлом является корень дерева \(B_2\). В свою очередь, самым левым дочерним узлом дерева \(B_2\) является корень дерева \(B_0\) (корни деревьев обозначены двойной линией).
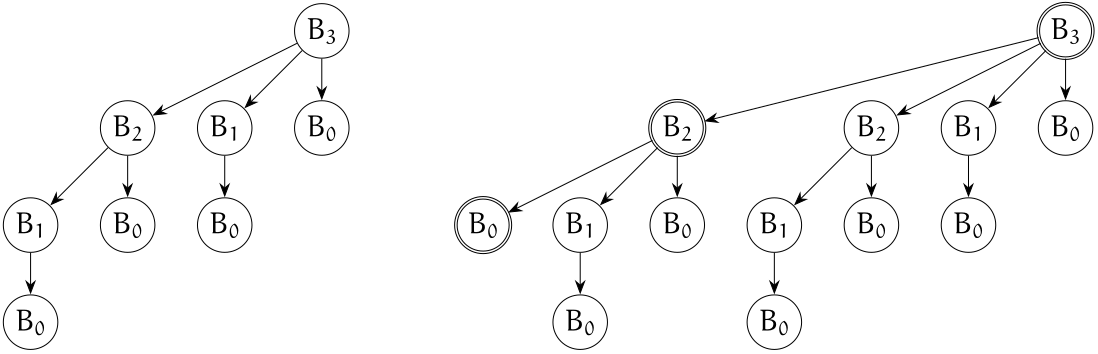
Биномиальное дерево обменов, в котором дочерние узлы с большими степенями находятся левее своих сестринских узлов, будем называть левосторонним. Заметим, что для операций корневой редукции (reduce, reduction) и сборки (gather) применяют правосторонние биномиальные деревья.
Корневой процесс выполняет \(\lceil \log_2 p \rceil\) операций передачи сообщений. Каждый некорневой процесс \(r\) выполняет один прием сообщения и не более \(\lfloor \log_2 r\rfloor\) операций передачи. Процесс определяет свое положение в дереве (номера родительского процесса и дочерних) основываясь только на своем номере \(rank\). Номер \(parent\) родительского процесса вычисляется путем сброса в значении \(rank\) первого установленного бита (find first set – FFS). Наборы команд многих процессоров включают соответствующую инструкцию FFS или инструкцию CTZ (count trailing zeros) подсчета числа завершающих нулевых битов. В приложении приведен универсальный алгоритм CTZ. Тогда номер родительского процесса может быть вычислен следующим образом:
или
Например, для вычисления родителя процесса \(10 = 1010_2\) сбрасываем второй бит и получаем номер родительского процесса \(parent = 8 = 1000_2\). Если реализация операций FFS и CTZ отсутствует, то поиск и установку необходимого бита можно реализовать последовательной проверкой в цикле разрядов числа \(rank\).
Дочерние узлы каждого процесса имеют номера больше \(rank\) и меньше \(p\). Они образуют следующую последовательность:
Количество дочерних узлов процесса \(rank\) не превышает \({CTZ}(rank)\). Справедливы следующие неравенства:
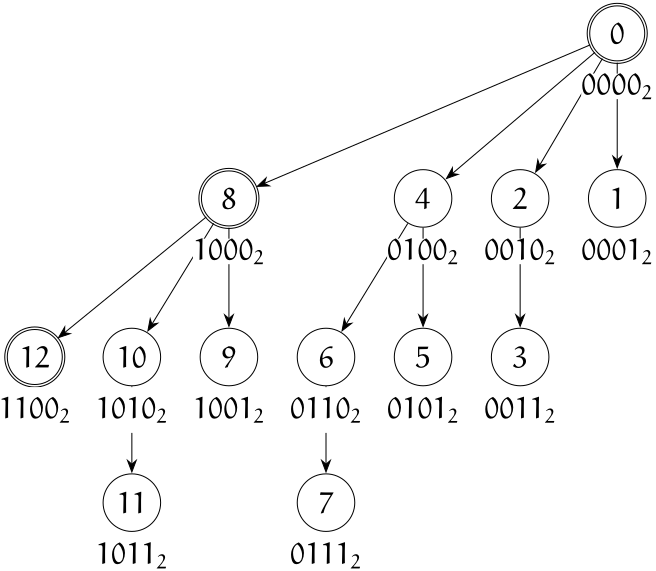
Исключение составляет корневой процесс. Номера его дочерних узлов образуют убывающую последовательность степеней двойки от наибольшей степень числа два, которая меньше \(p\), до единицы. Число дочерних узлов равно \(\lceil \log_2 p \rceil\). Для вычисления номера левого дочернего узла необходимо выполнить округление значения \(p - 1\) до ближайшей снизу степени числа два. Последнее может быть реализована тривиальным циклическим алгоритмом или поразрядной операцией FLP2 (rounding down to next power of 2) [60] . Например, для \(p = 16\) процессов первый дочерний узел корня имеет номер \({FLP2}(15) = 8\), а при \(p = 9\) дочерним узлом корня является \({FLP2}(8) = 4\). Таким образом, номера дочерних узлов корня образуют убывающую последовательность степеней двойки \({FLP2}(p - 1), \ldots, 2, 1\). Например, на рис. 3.14 корень имеет четыре дочерних узла \(8, 4, 2, 1\).
Выше мы рассмотрели основные шаги алгоритма для случая когда корнем операции является процесс 0. В приведенном ниже псевдокоде корнем операции может быть люой процесс. Это реализуется путем введения новой нумерации процессов, в которой корневой процесс всегда имеет виртуальный номер 0. Каждый процесс вычисляет свой относительный номер \(srank\) – номер процесса относительно корневого (relative rank, shifted rank):
Корневой процесс всегда имеет \(srank\) равный нулю.
Перед выполнением обменов происходит обратный переход от относительных номеров процессов к исходным:
algorithm BcastBinomial(buf, count, type, root)
  srank = (rank - root + p) % p      // Переход к root = 0
  if srank > 0 then
    mask = (1 << FFS(srank)) >> 1
    // Сброс в srank первого установленного бита
    sparent = srank xor mask
    parent = (parent + root) % p
    Recv(buf, count, type, parent)  // Прием от родителя
  else
    mask = FLP2(p - 1) // Ближайшая снизу к p - 1 степень двойки
  end if
  while mask > 0 do
    schild = srank or mask
    if schild < p then
      child = (schild + root) % p
      Send(buf, count, type, child) // Передача дочерним
    end if
    mask = mask >> 2
  end while
end algorithm
Время работы алгоритма биномиального дерева определяется временем работы корневого процесса, которое складывается из времени передачи сообщений \(\left\lceil\log_2 p\right\rceil\) дочерним узлам:
Время выполнения алгоритма совпадает с нижней границей Bcast по латентности – алгоритм биномиального дерева для сообщений небольших размеров является оптимальным (при небольших сообщениях вклад \(\alpha\) в итоговое время доминирующий). Однако время его выполнения в \(\log_2 p\) раз больше нижней границы Bcast по пропускной способности.
В алгоритме биномиального дерева номер процесса \(rank\) трактуется как число в двоичной системе исчисления, обобщим алгоритм для случая системы исчисления с произвольным основанием \(k \in \{2, 3, \ldots, p - 1\}\).
3.8. Алгоритм \(k\)-номиального дерева
Процессы логически выстраиваются в дерево обменов, представляющее собой совокупность \(k\)-номиальных деревьев (\(k\)-nomial tree). При \(k = 2\) дерево называется биномиальным (binomial tree), а при \(k = 3\) – триномиальным (trinomial tree). В англоязычной литературе можно встретить названия quadnomial tree для \(k = 4\) и octanomial tree для \(k = 8\). В русскоязычной литературе эти термины не получили широкого распространения. На рис. 3.15.а и рис. 3.15.б показаны примеры организации 14 процессов в триномиальное и 4-номиальное деревья. При \(k=3\) операция Bcast завершается за 5 шагов, а при \(k=4\) за 6.
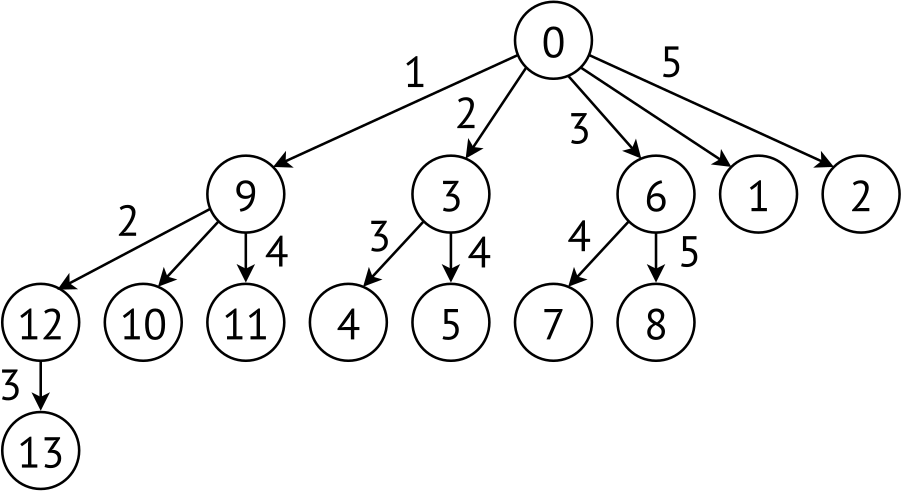
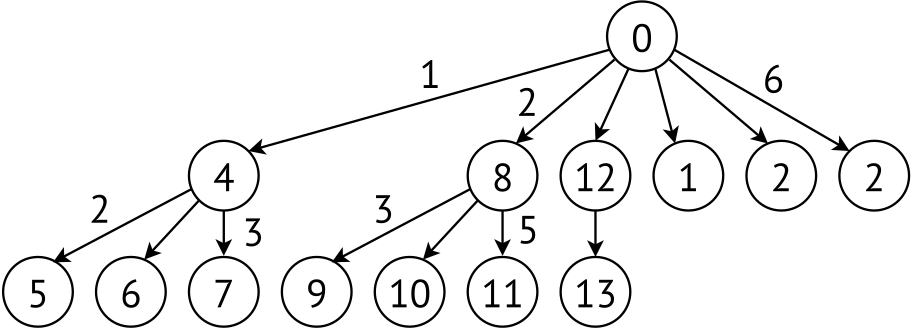
Номера процессов трактуются как числа, записанные в системе счисления с основанием \(k\) (radix, base). В каждом разряде номера процесса может стоять цифра из множества \(\{0, 1, \ldots, k - 1\}\). Например, номер процесса 12 в системах счисления с основаниями \(k \in \{3, 4\}\) имеет следующие представления:
Номер родительского процесса вычисляется путем сброса в номере \(rank\) текущего процесса самого младшего разряда с положительным весом (least significant digit). Например, в биномиальном дереве номер родителя для процесса \(rank=12=1100_2\) равен \(8 = 1000_2\), который получен путем сброса в числе 12 третьего бита (младшего значащего разряда). Аналогично, в триномиальном дереве родительским для процесса \(12 = 110_3\) является узел \(9 = 100_3\), а в 4-номиальном дереве родительским для процесса \(12=30_4\) является процесс 0.
Поиск младшего ненулевого разряда может быть реализован специальными инструкциями процессора или универсальным алгоритмом на основе поиска в цикле младшего значащего разряда. Для этого в порядке возрастания перебираются степени числа \(k\):
Если остаток от деления номера процесса \(rank\) на \(k^i\) больше нуля, то искомый разряд найден. Выполняется его сброс и прием сообщения от родительского процесса.
Количество дочерних узлов любого процесса не превышает значения
Пусть найденный младший значащий разряд в \(rank\) соответствует степени \(k^q\). Тогда для нумерации дочерних узлов процесса \(rank\) доступны его младшие нулевые разряды, соответствующие степеням
Номер каждого дочернего узла образуется путем установления одного из младших нулевых разрядов. Заметим, что в любом из доступных \(q\) разрядов может быть записана цифра из множества \(\{1, 2, \ldots, k-1\}\). Поэтому число дочерних процессов узла \(rank\) не превышает \((k-1)q\). Таким образом, у корневого процесса количество дочерних узлов не превышает значения \((k-1)\left\lceil\log_k p\right\rceil\).
Например, в биномиальном дереве для нумерации дочерних узлов процесса \(8=1000_2\) доступно три младших разряда, которые соответствуют степеням \(2^2, 2^1, 1\). Таким образом процесс 8 имеет дочерние узлы с номерами:
В 4-номиальном дереве в каждом разряде могут стоять цифры 0, 1, 2 и 3, потому процесс \(4=10_4\) имеет дочерние узлы:
В приведенном ниже псевдокоде номера дочерних узлов перебираются в цикле путем прохода по убыванию степеней числа \(k\).
algorithm BcastKnomial(buf, count, type, root)
  srank = (rank - root + p) % p       // Переход к root = 0
  mask = 1
  while mask < p do
    if srank % (k * mask) > 0 then
      // Сброс разряда в srank
      sparent = floor(srank / (k * mask)) * (k * mask)
      parent = (sparent + root) % p
      Recv(buf, count, type, parent)  // Прием от родителя
      break
    end if
    mask = mask * k
  end while
  mask = mask / k
  while mask > 0 do
    for (r = 1; r < k; r = r + 1)
      schild = srank + mask * r
      if schild < p then
        child = (schild + root) % p
        Send(buf, count, type, child)
      end if
    end for
    mask = mask / k
  end while
end algorithm
Время работы алгоритма – это время корневого процесса на передачу сообщений \((k-1)\left\lceil\log_k p\right\rceil\) дочерним узлам:
Рекомендуем читателю самостоятельно оценить время выполнения внутреннего процесса \(rank\) и листового.
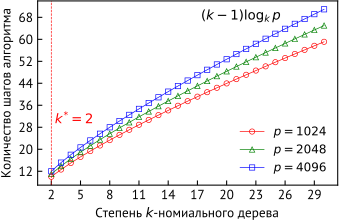
Ответим на вопрос – какое значение \(k\) следует выбирать на практике для минимизации времени операции Bcast? На рис. 3.16 приведена зависимость числа шагов алгоритма \(k\)-номиального дерева от степени \(k\). Видно, что из дискретных значений \(k \in \{2, 3, \ldots p - 1\}\) целесообразно выбирать \(k^{*}=2\), при котором алгоритм выполняет наименьшее число шагов.
Мы определили, что алгоритм биномиального дерева является оптимальным для сообщений небольших размеров. Теперь следует предложить алгоритм для сообщений больших размеров, который будет по пропускной способности близок к нижней границе \(m\beta\) операции Bcast.
3.9. Конвейерный алгоритм с сегментацией сообщения
В этом алгоритме процессы выстраиваются в цепочку, а исходное сообщение разбивается на \(\left\lceil\frac{m}{s}\right\rceil\) сегментов по \(s\) байт, \(s\) – это входной параметр алгоритма. Корневой процесс передает сегмент за сегментом своему соседу. Каждый внутренний процесс цепочки принимает текущий сегмент и одновременно с этим передает ранее принятый (если такой имеется). На рис. 3.17 показан пример для четырех процессов и разбиения сообщения на три сегмента. Подразумеваться, что каналы связи поддерживают дуплексный режим работы (full duplex) – каждый процесс может одновременно передавать и принимать сообщение. Это позволяет внутренним процессам цепочки выполнять операцию SendRecv за время \(\alpha + s\beta\). Если каналы связи полудуплексные (half duplex), то время каждого внутреннего процесса увеличиться в два раза – приём текущего сегмента будет выполняться только после завершения передачи предыдущего (\(2(\alpha + s\beta)\)). Следовательно и итоговое время работы алгоритма увеличиться в два раза.
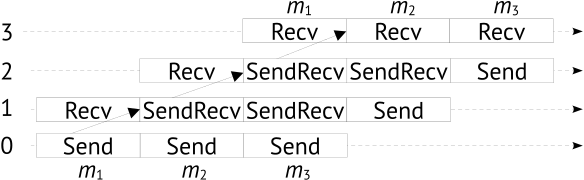
Ниже приведен псевдокод, в котором \(count\) элементов типа \(type\) разбивается на \(\left\lceil\frac{m}{s}\right\rceil\) сегментов. Каждый сегмент содержит \(s / \mathrm{sizeof}(type)\) элементов типа \(type\). Все процессы в цикле выполняют прием и/или передачу сегментов. Размер сообщения может не делиться без остатка на \(s\), поэтому последний сегмент может быть неполным. Для этого алгоритм вычисляет в переменной \(cur\_seg\_count\) размер текущего сегмента.
algorithm BcastPipeline(buf, count, type, root)
  next = (rank + 1) % p
  prev = (rank - 1 + p) % p
  srank = (rank - root + p) % p

  // Число элементов типа type в сегменте
  seg_count = s / sizeof(type)
  nsegs = ceil(count / seg_count)
  if count < seg_count then
    // Сообщение меньше сегмента
    seg_count = count
  end if
  seg_size = seg_count * sizeof(type)
  cur_seg_count = seg_count

  if srank = 0 then                    // Корень операции
    for (seg = 0; seg < nsegs; seg++)
      if seg = nsegs - 1 and count % seg_count then
        // Последний сегмент может быть неполным
        cur_seg_count = count % seg_count
      end if
      Send(buf + seg * seg_size, cur_seg_count, next)
    end for
  else if srank = p - 1 then           // Последний процесс цепочки
    for (seg = 0; seg < nsegs; seg++)
      if seg = nsegs - 1 and count % seg_count then
        cur_seg_count = count % seg_count
      Recv(buf + seg * seg_size, cur_seg_count, prev)
    end for
  else                                 // Внутренний процесс
    Recv(buf, seg_count, type, prev)   // Прием первого сегмента
    for (seg = 1; seg < nsegs; seg++)
      if seg = nsegs - 1 and count % seg_count then
        cur_seg_count = count % seg_count
      SendRecv(buf + (seg - 1) * seg_size, seg_count, next,
               buf + seg * seg_size, cur_seg_count, prev)
    end for
    Send(buf + (nsegs - 1) * seg_size, cur_seg_count, next)
  end if
end algorithm
Время выполнения алгоритма определяется временем получения заключительного сегмента последним процессом цепочки
Из полученного выражения найдем оптимальный размер сегмента, при котором время алгоритма минимально (в рамках рассматриваемой модели):
Откуда
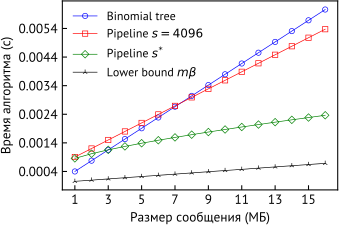
На рис. 3.18 показано модельное время выполнения алгоритма биномиального дерева и конвейерного алгоритма с сегментом 4096 байт и сегментом оптимального размера \(s^{*}\). Нижняя кривая показывает нижнюю границу \(m\beta\) времени операции Bcast для сообщений больших размеров. Видно, что при рассылке операцией Bcast сообщения меньше 3 МБ наименьшее время требуется алгоритму биномиального дерева, а для сообщений больших размеров лучшие результаты демонстрирует конвейерный алгоритм с оптимальным размером сегмента. На практике целесообразно провести серию экспериментов и определить наилучшее значение сегмента. Найденное значение \(s^{*}\) является хорошим начальным приближением для такого поиска.
В этом алгоритме число операций Send/Recv линейно зависит от числа процессов и количества сегментов. Оценим во сколько раз алгоритм превышает нижнюю границу \(m\beta\) времени Bcast по пропускной способности. Найдем множитель при \(\beta\) в отношении \(t_{{Pipeline}}\) к нижней границе \(m\beta\):
где \(n = \frac{m}{s}\) – число сегментов. Видно, что при использовании одного сегмента \(n=1\) отклонение от нижней границы по пропускной способности будет в \(p-1\) раз. При числе сегментов \(n \geq p-1\) отклонение от нижней границы становится меньше двух и убывает с ростом \(n\).
И так для сообщений небольших размеров мы получили алгоритм биномиального дерева, а для больших сообщений – конвейерный алгоритм с сегментацией сообщений. Остался открытым вопрос о выборе алгоритма для сообщений средних размеров. Объединим идеи бинарного дерева и конвейерной передачи сегментов в следующем алгоритме.
3.10. Алгоритм бинарного дерева с сегментацией сообщения
Процессы выстраиваются в бинарное дерево. Исходное сообщение разбивается на \(\left\lceil\frac{m}{s}\right\rceil\) сегментов по \(s\) байт. Корень передает сегмент за сегментом своим левому и правому дочерним процессам. На рис. 3.19 показан пример для 7 процессов и трёх сегментов сообщения. На первом шаге корень передает первый сегмент процессу 1, на втором шаге этот же сегмент передается процессу 2, после чего корень начинает передачу дочерним узлам второго фрагмента.
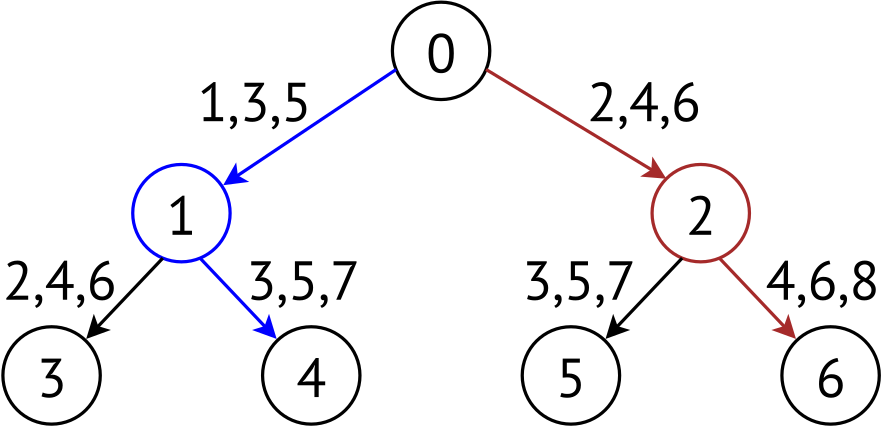
На третьем шаге процесс 1 одновременно передает первый сегмент и принимает второй – используется полнодуплексный режим (рис. 3.20). На четвертом шаге в полнодуплексном режиме работает процесс 2. Таким образом полнодуплексный режим у процессов 1 и 2 используется не каждом шаге, а только через шаг, что не позволяет полностью использовать возможности каналов связи – достигнуть использования всей доступной пропускной способности (full bandwidth).
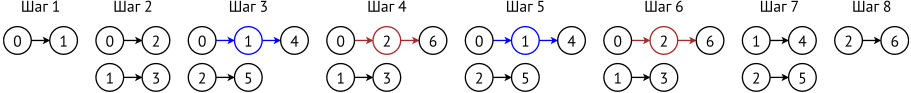
Время выполнения алгоритм определяется высотой дерева \(h\). Первый сегмент достигнет листа через \(h = \lceil\log_2 p \rceil\) шагов. На прием оставшихся сегментов потребуется еще \(n - 1\) шагов, где \(n = \left\lceil\frac{m}{s}\right\rceil\) – число сегментов. Время выполнения алгоритма определяется временем получения последнего сегмента самым правым листом:
Из выражения \(t_{{PipelinedBinTree}}\) найдем оптимальный размер сегмента, при котором время алгоритма минимально:
Откуда
На рис. 3.21 показано модельное время выполнения алгоритмов операции Bcast. Алгоритм биномиального дерева показывает лучшие результаты для сообщений меньше 120КБ, для сообщений в интервале [120KB, 20MB] лучшие результаты у алгоритма бинарного дерева с сегментацией сообщения. Для сообщений больше 50МБ наименьшее время у конвейерного алгоритма с оптимальным размером \(s^{*}\) сегмента. На практике можно провести измерения времени выполнения алгоритмов на целевой системе для различных \(p\), \(m\) и сформировать правило динамического выбора алгоритма с наименьшим временем для заданного числа процессов и размера сообщений.
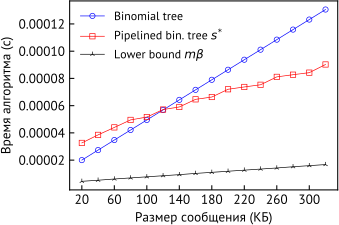
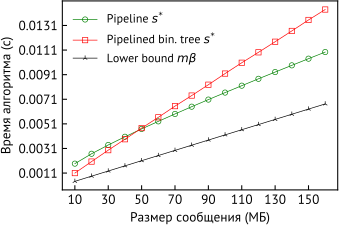
3.11. Алгоритм на основе Scatter и Allgather
Рассмотрим два алгоритма Bcast для сообщений больших размеров, которые не используют конвейерную передачу сегментов. Их ключевая идея – это расщепление операции Bcast на две коллективные операции – Scatterv с последующим вызовом Allgatherv [61] . Алгоритм имеет ограничение – он применим для больших размеров сообщений \(count \ge p\).
Исходное сообщение разбивается на \(p\) блоков по \(count / p\) элементов типа \(type\), которые рассылаются операцией Scatterv всем процессам. После чего все блоки собираются в каждом процессе операцией Allgatherv. Фаза Scatterv реализуется алгоритмом биномиального дерева, а операция Allgatherv алгоритмом рекурсивного удваивания (recursive doubling) или кольцевым алгоритмом. Рассмотрим подробнее версию с Allgatherv на базе кольца. Ниже приведен псевдокод алгоритма.
На этапе Scatterv корневой процесс передает каждому дочернему узлу блоки для его поддерева. На рис. 3.22 показано биномиальное дерево, в котором процесс 4 принимает от корня блоки 4-7, процесс 2 блоки 2-3, а листовой процесс 1 только свой блок. Внутренние узлы дерева принимаю блоки и передают соответствующие части своим дочерним процессам. После окончания фазы Scatterv каждый процесс содержит в буфере \(buf\) порядка \(count / p\) элементов типа \(type\) начиная с позиции \(srank\) (новая нумерация процессов с корнем 0).
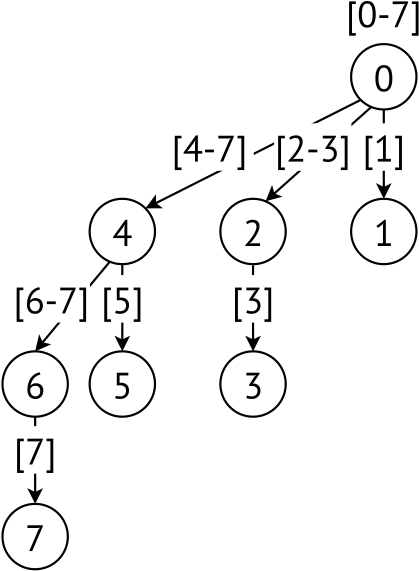
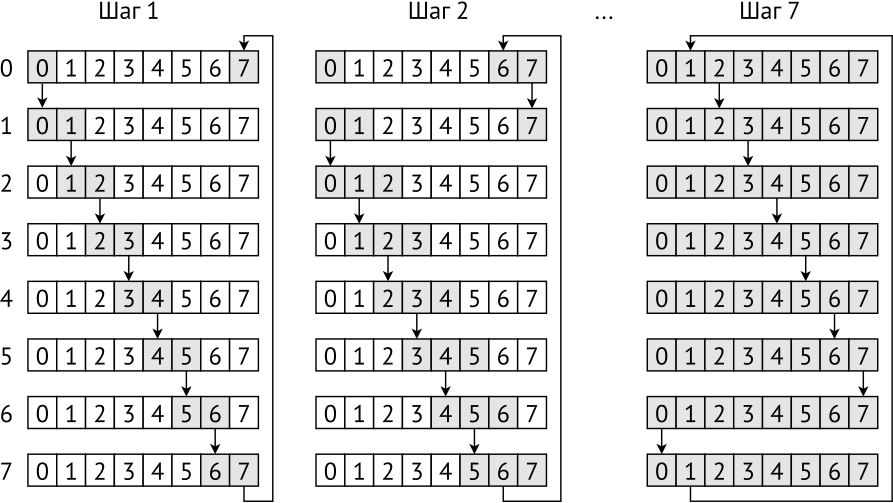
Каждый процесс поддерживает в переменной \(recv\_count\) количество элементов, которые он получил от родителя для его поддерева. Обратим внимание, что стандарт MPI позволяет указывать в операции Recv большее число принимаемых элементов, чем в действительности может содержать входящее сообщение. Поэтому при приеме блоков от родителя мы указываем оценку сверху \(recv\_max\) ожидаемого числа элементов. Это упрощает алгоритм. Реальное число принятых элементов определяется функцией GetRecvCount. На рис. 3.23 приведен пример кольцевого алгоритма Allgatherv для 8 процессов.
algorithm BcastScatterAllgatherRing(buf, count, type, root)
  srank = (rank - root + p) % p
  block = ceil(count / p)
  mask = 1                       // Scatterv: прием блоков от родителя для поддерева
  while mask < p do
    if srank and mask then
      parent = (rank - mask + p) % p
      recv_max = count - srank * block
      if recv_max <= 0 then
        recv_count = 0
      else
        Recv(buf + srank * block * sizeof(type), recv_max, type, parent, status)
        recv_count = GetRecvCount(status, type) // Число принятых элементов типа type
      end if
      break
     end if
     mask = mask * 2
  end while
  mask = mask / 2                               // Scatterv: биномиальное дерево
  if rank = root then recv_count = count
  while mask > 0 do
    if srank + mask < p then
      send_count = recv_count - block * mask
      if send_count > 0 then
        child = (rank + mask) % p
        Send(buf + block * (srank + mask) * sizeof(type),
             send_count, type, child)
        recv_count = recv_count - send_count
      end if
    end if
    mask = mask / 2
  end while

  // Allgatherv: кольцевой алгоритм
  left = (rank - 1 + p) % p
  right = (rank + 1) % p
  send_block = srank
  recv_block = (srank - 1 + p) % p
  for (i = 1; i < p; i = i + 1)
    recv_count = min(block, count - recv_block * block)
    if recv_count < 0 then recv_count = 0
    recv_offset = recv_block * block * sizeof(type)
    send_count = min(block, count - send_block * block)
    if send_count < 0 then send_count = 0
    send_offset = send_block * block * sizeof(type)
    SendRecv(buf + send_offset, send_count, type, right,
             buf + recv_offset, recv_count, type, left)
    send_block = recv_block
    recv_block = (recv_block - 1 + p) % p
  end for
end algorithm
Читателю предлагается самостоятельно разобрать случай когда \(count\) не делится без остатка на \(p\) – выяснить как по дочерним процессам распределяются блоки.
Оценим время выполнения алгоритма. Время алгоритма биномиального дерева для Scatterv определяется временем корня, который последовательно за \(\left\lceil\log_2p\right\rceil\) итераций передает своим дочерним процессам группы со следующим количеством блоков:
Каждый блок по \(count / p\) элементов типа \(type\) и занимает \(m/p\) байт. Тогда время этапа Scatterv:
На этапе Allgatherv все процессы выполняют одинаковое число шагов. В случае использования кольцевого алгоритма каждый процесс выполняет \(p-1\) операций SendRecv блоками по \(m/p\) байт:
Здесь предполагается, что каналы связи поддерживают дуплексный режим – операции Send и Recv выполняются одновременно. Итоговое время алгоритма Bcast на основе Scatterv с биномиальным деревом и операцией Allgatherv на базе кольца:
В случае реализации Allgatherv рекурсивным удваиванием каждый процесс выполняет \(\log_2 p\) операций SendRecv группами блоков возрастающей длины:
Время выполнения Bcast в этом случае составит:
На рис. 3.24 приведено время выполнения алгоритмов операции Bcast на модельных данных. На размерах сообщений до 30КБ лучшие результаты показывает алгоритм биномиального дерева. На сообщениях [30КБ, 70МБ] наименьшее время у алгоритма ScattervAllgathervRdbl, а на сообщениях больше 70MB лучшие результаты показывает конвейерный алгоритм с оптимальным размером сегмента.
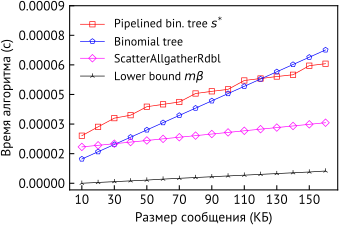
Важно отметить, что в отличие от рассмотренных ранее алгоритмов с сегментацией сообщения, в этих алгоритмах на этапах Scatterv и Allgatherv на базе рекурсивного удваивания размер сообщения непостоянный – передаются диапазоны блоков. Это может привести к использованию в конкретной реализации библиотеки MPI различных протоколов Send/Recv, например переключению с протокола \(eager\), для коротки сообщений, на протокол \(randezvous\) для сообщений больших размеров. В конечном счете это может как положительно, так и отрицательно сказаться на времени выполнения алгоритма.
В табл. приведена сводка рассмотренных алгоритмов операции Bcast и размеры сообщений, которые передаются на отдельных шагах алгоритмов.
| Алгоритм | Время выполнения | Размер сообщений |
|---|---|---|
Linear |
\((p - 1)(\alpha + m\beta)\) |
\(m\) |
Pipeline |
\((p - 1)(\alpha + m\beta)\) |
\(m\) |
Параллельных цепочек (\(k\)-chain) |
\(\left(k + \left\lfloor\frac{p-1}{k}\right\rfloor - 1\right)(\alpha + m\beta)\) |
\(m\) |
С оптимальным числом цепочек (\(k\)-chain-opt) |
\((2\sqrt{p-1} - 1)(\alpha + m\beta)\) |
\(m\) |
С переменным числом цепочек (\(k\)-chain-var) |
\(\left\lceil (\sqrt{8(p-1) + 1} - 1)/2 \right\rceil (\alpha + m\beta)\) |
\(m\) |
\(k\)-ичного дерева (\(k\)-ary tree) |
\(k\left\lfloor\log_k p\right\rfloor (\alpha + m\beta)\) |
\(m\) |
\(k\)-номиального дерева (\(k\)-nomial tree) |
\((k-1)\left\lceil\log_k p\right\rceil (\alpha + m\beta)\) |
\(m\) |
Конвейерный с сегментацией сообщения |
\(\left(p-1 + \frac{m}{s} - 1\right)(\alpha + s\beta)\) |
\(s\) |
Бинарного дерева с сегментацией сообщения |
\(2\left(\lceil\log_2 p\rceil + \left\lceil\frac{m}{s}\right\rceil - 1\right)(\alpha + s\beta)\) |
\(s\) |
ScattervAllgathervRing |
\(\left(\log_2 p + p - 1\right)\alpha + 2\frac{(p-1)m}{p}\beta\) |
\(\frac{m}{p}, \frac{2m}{p}, \ldots, \frac{2^{\log_2 p - 1}m}{p}\) |
ScattervAllgathervRdbl |
\(2\log_2 p\alpha + 2\frac{(p-1)m}{p}\beta\) |
\(\frac{m}{p}, \frac{2m}{p}, \ldots, \frac{2^{\log_2 p - 1}m}{p}\) |
3.12. Алгоритмы оптимальные по пропускной способности
Возможно ли построить алгоритм операции Bcast, который будет достигать нижней границы времени Bcast для больших сообщений (full bandwidth algorithm)? Ответ утвердительный. Известно несколько алгоритмов, например [28] , [62] , но они требуют предварительных вычислений позиции процессов в графах и деревьях специального вида. В [62] предлагается использовать циркулянтный граф, а главная идея [28] – построить два бинарных дерева, в которые входит каждый процесс и на каждом шаге выполняет одновременный прием и передачу сегментов.
3.13. Операция Scatter
Операция Scatter – это персонифицированная широковещательная рассылка. Все процессы получают сообщения одинакового размера, но из разных позиций буфера отправки \(sbuf\), который содержит \(p\) блоков:
MPI_Scatter(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)
Корневой процесс \(root\) передает \(scount\) элементов типа \(stype\) каждому процессу \(rank\) начиная с адреса
Процессы принимают сообщение в буфер \(rbuf\) как \(rcount\) элементов типа \(rtype\). Тип принимаемых элементов \(rtype\) может отличаться от типа отправляемых \(stype\). Например, корень может отправить каждому процессу персональную строку матрицы из 100 целых чисел, а принимающий процесс может сохранить сообщение в памяти как столбец из 100 элементов. Требования стандарта выполнены, сигнатуры типа отправки \(stype\) (MPI type signature) и приема \(rtype\) совпадают, совпадает и их размер – 100 элементов типа . Параметры \(sbuf\), \(scount\) и \(stype\) значимы только на стороне корня, остальным процессам следует их игнорировать.
Стандарт MPI определяет операцию Scatterv c нерегулярными размерами сообщений.
MPI_Scatterv(sbuf, scounts[p], displs[p], stype, rbuf, rcount, rtype, int root, comm)
Корень передает процессу \(rank\) сообщение из \(scounts[rank\)] элементов типа \(stype\) начиная со смещения
Для операции Scatter мы рассмотрим два основных алгоритма её реализации – линейный и алгоритм биномиального дерева. Для нерегулярной версии Scatterv, как правило, библиотеки реализуют только линейный алгоритм. Мы не будем его рассматривать, так как он аналогичен соответствующему алгоритму для Scatter.
3.13.1. Линейный алгоритм
Ниже приведен псевдокод линейного алгоритма (linear, flat tree) для Scatter. Корневой процесс выполняет \(p\) операций Send, включая передачу самому себе – копирование из своего буфера \(sbuf\) в \(rbuf\). Время выполнения алгоритма
algorithm ScatterLinear(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)
  if rank = root then
    for (i = 0; i < p; i++)
      if i = root then
        SendRecv(sbuf + i * scount * sizeof(stype), scount, stype, i,
                 rbuf, rcount, rtype, i)
      else
        Send(sbuf + i * scount * sizeof(stype), scount, stype, i)
      end if
    end for
  else
    Recv(rbuf, rcount, rtype, root)
  end if
end algorithm
3.13.2. Алгоритм биномиального дерева
Теперь рассмотрим алгоритм биномиального дерева. Корнем дерева может быть процесс отличный от нуля, поэтому в начале вводится новая нумерация, в которой корень имеет \(srank = 0\). Это упрощает вычисление номера родительского узла и дочерних. Внутренним процессам дерева требуется временный буфер для приема сообщения от родителя.
Размер буфер не превышает \(m\cdot p / 2\) байт – суммарный размер сообщений для потомков любого поддерева. Если корневым является ненулевой процесс, то он выполняет перестановку элементов во временном буфере \(tmpbuf\) так, чтобы элементы в нем следовали в соответствии с новой нумерацией: \([root, root + 1, \ldots, (root - 1 + p) \mathbin{\%} p\)]. Листовые процессы принимают сообщение сразу в буфер \(rbuf\). Внутренние процессы принимают и передают сообщения в свои поддеревья использую тип . Это связно с тем, что у некорневых процессов отсутствует информация о типе данных корня, параметры \(scount\) и \(stype\) значимы только в корневом процессе. Кроме этого, использование позволяет не тратить время на разворачивание в памяти сообщений в соответствии с сигнатурой типа \(rtype\). Детали формирования структуры дерева приведены в разделе 3.7. В переменной \(cur\_count\) поддерживается суммарный размер сообщений, которые хранятся в буфере процесса \(sbuf\) (если \(root = 0\)) или буфере \(rbuf\) при \(root > 0\). Ниже приведен псевдокод алгоритма.
algorithm ScatterBinomial(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)
  srank = (rank - root + p) % p      // Переход к root = 0
  if rank = root then
    m = scount * sizeof(stype)
  else
    m = rcount * sizeof(rtype)
  end if
  cur_count = 0

  if (rank != root) and (srank % 2 = 0) then
    tmpbuf = AllocMem(m * p / 2) // Временный буфер для внутренних узлов дерева
  end if
  if rank = root then
    if root != 0 then
      tmpbuf = AllocMem(m * p)
      // Перестановка элементов в tmpbuf
      Copy(sbuf + rank * scount * sizeof(stype),
           scount * (p - rank), stype, tmpbuf, m * (p - rank))
      Copy(sbuf, rank * scount, stype, tmpbuf + m * (p - rank), rank * m)
      cur_count = m * p
    else
      cur_count = scount * p
    end if
  end if
  mask = 1
  while mask < p do                        // Приём от родителя
    if srank and mask then
      parent = (rank - mask + p) % p
      if srank % 2 then
        Recv(rbuf, rcount, rtype, parent)  // Лист в дереве
      else
        Recv(tmpbuf, m * p / 2, MPI_BYTE, parent, status)
        cur_count = GetRecvCount(status, MPI_BYTE)
      end if
      break
    end if
    mask = mask * 2
  end while
  mask = mask / 2
  while mask > 0 do                        // Передача дочерним
    if srank + mask < p then
      child = (rank + mask) % p
      if (rank = root) and (root = 0) then
        subtree_count = cur_count - scount * mask
        Send(sbuf + mask * scount * sizeof(stype), subtree_count, stype, child)
      else
        subtree_count = cur_count - m * mask
        Send(tmpbuf + m * mask, subtree_count, MPI_BYTE, child)
      end if
      cur_count = cur_count - subtree_count
    end if
    mask = mask / 2
  end while
  // Копирование своего сообщения в rbuf
  if (rank = root) and (root = 0) then
    Copy(sbuf, scount, stype, rbuf, rcount, rtype)
  else if srank % 2 = 0 then
    Copy(tmpbuf, m, MPI_BYTE, rbuf, rcount, rtype)
  end if
end algorithm
Время алгоритма биномиального дерева для операции Scatter определяется временем корня, который последовательно за \(\left\lceil\log_2p\right\rceil\) итераций передает своим дочерним процессам сообщения для их поддеревьев (потомков). Суммарные размеры сообщений, передаваемые корнем дочерним узлам образуют последовательность:
Тогда время выполнения алгоритма:
4. Широковещательный прием Gather
В операции Gather каждый процесс передает корню \(root\) сообщение из буфера отправки \(sbuf\), содержащего \(scount\) элементов типа \(stype\). Корневой процесс \(root\) принимает \(rcount\) элементов типа \(rtype\) от каждого процесса коммуникатора \(comm\) в буфер \(rbuf\). Буфер \(rbuf\) должен вмешать сообщения всех процессов – \(p \cdot rcount\) элементов типа \(rtype\):
MPI_Gather(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)Стандарт MPI определяет операцию Gatherv c нерегулярными размерами сообщений – каждый процесс может передавать разное число \(scount\) элементов. Корневому процессу известны размеры всех сообщений, которые указываются в массиве \(rcounts[p\)]:
MPI_Gatherv(sbuf, scount, stype, rbuf, rcounts[p], displs[p], rtype, root, comm)Для реализации операций Gather в основном применяются два алгоритма – биномиальное дерево и линейный алгоритм (плоское дерево).
4.1. Алгоритм плоского дерева
В алгоритме плоского дерева (linear tree, flat tree) корневой процесс последовательно принимает сообщения от всех процессов \(0, 1, \ldots, p-1\). Сообщение из своего буфера отправки \(sbuf\) он копирует в позицию \(root\) буфер приема \(rbuf\). Наибольшим временем выполнения характеризуется корневой процесс. Очевидно, что время выполнения линейно зависит от числа процессов \(p\) и размер сообщения \(m = scount \cdot sizeof(stype)\):
algorithm GatherLinear(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)
  if rank != root then
    Send(sbuf, scount, stype, root)
  else
    for (i = 0; i < p; i++)
      if i != root then
        Recv(rbuf + i * rcount * sizeof(rtype), rcount, rtype, i)
      else
        // Копирование из sbuf в rbuf
        Copy(sbuf, scount, stype, rbuf + root * rcount * sizeof(rtype),
             rcount, rtype)
      end if
  end if
end algorithm
4.2. Алгоритм биномиального дерева
Как следует из названия в этом алгоритме процессы выстраиваются в биномиальное дерево (binomial tree), корнем которого является процесс \(root\). Дерево растет вправо, чтобы совместить выполнение операций Send/Recv в поддеревьях. Структура дерева аналогична биномиальному дереву для операции корневой редукции (см. раздел. link:[reduce_bmtree_commutative]). За исключением того, что в операции Gather процесс передает родителю не одно сообщение, а блок – сообщения всех потомков. Кроме этого внутренним узлам и листьям не доступна информация о типе сообщения корня, параметры \(rcount\) и \(rtype\)). Основное время выполнения алгоритма приходится на корневой процесс. Листовые узлы передают своё сообщение родителю и сразу выходят из операции. Если корнем является процесс отличный от 0, то процессы вводят новую нумерацию – циклически смещенную на значение \(root\): \(srank = (rank - root + p) \mathbin{\%} p\). Это упрощает вычисление положения процесса в биномиальном дереве.
На рис. 4.1 приведены примеры биномиальных деревьев для \(p=9\) с корнями в процессах 0 и 8. Во втором случае, \(root = 8\), корень формирует результат во временном буфере, положения блоков не соответствует исходной нумерации процессов. Поэтому на последнем шаге необходимо переставить два интервала элементов для установления канонического порядка в \(rbuf\).
Ниже приведен псевдокод алгоритма. На первом шаге выполняется создание временного буфера \(tmpbuf\). Очевидно, что для внутреннего узла достаточно выделять буфер, вмещающий количество блоков не превосходящее число потомков узла. Мы для простоты выделяем буфер для \(p\) блоков. В переменной \(count\) формируется количество элементов во временном буфере. Корень и внутренние узлы выполняют не более \(log_2p\) операций приема сообщений, после чего внутренние узлы передают результат родителю.
algorithm GatherBinomial(sbuf, scount, stype, rbuf, rcount, rtype, root, comm)
  srank = (rank - root + p) % p
  if rank = root then
    if root = 0 then
      tmpbuf = rbuf
    else
      tmpbuf = AllocMem(p * rcount * sizeof(rtype))
    end if
    // Копирование в tmpbuf
    Copy(sbuf, scount, stype, tmpbuf, rcount, rtype)
    count = rcount
  else if srank % 2 = 0 then
    // Внутренний узел
    tmpbuf = AllocMem(p * scount * sizeof(stype))
    count = scount
    rcount = scount
    rtype = stype
  else
    // Листья
    tmpbuf = sbuf
    count = scount
  end if
  for (mask = 1; mask < p; mask = mask * 2)
    if srank and mask = 0 then     // Корень и внутренние узлы принимают сообщения
      schild = srank or mask
      if schild < p then
        blocks = schild - srank
        if blocks > p - schild then blocks = p - schild
        child = (schild + root) % p
        Recv(tmpbuf + count * sizeof(rtype), rcount * p - count, rtype, child)
        count = count + blocks
      end if
    else                           // Внутренние узлы и листья передают родителю
      sparent = srank xor mask
      parent = (srank + root) % p
      Send(tmpbuf, count, stype, parent)
    end if
  end for
  if rank = root and root != 0 then
    // Перестановка блоков в rbuf в каноническом порядке
    Copy(tmpbuf, rbuf + root * rcount * sizeof(rtype), (p - root) * rcount)
    Copy(tmpbuf + (p - root) * rcount * sizeof(rtype), rbuf, root * rcount)
  end if
end algorithm
Оценим время выполнения алгоритма для случая числа процессов равного степени двойки. Обобщение на произвольное значение \(p\) не представляет сложности. Наибольшим временем характеризуется корневой процесс. Он выполняет \(\log_2 p\) операций Recv для сообщений с числом блоков \(1, 2, 4, \ldots, 2^{\log_2(p) - 1}\):
где \(m = scount \cdot sizeof(stype)\).
Если корнем выбран процесс \(root > 0\), то в конце алгоритмы возникают дополнительные накладные расходы на перестановку \(p\) блоков в \(rbuf\): \(mp\lambda\).
Appendix A: Приложение
A.1. Функции округления и операций с битами
A.1.1. Функции пол и потолок
Округление вещественного числа \(x\) до меньшего ближайшего целого числа обозначается как \(\lfloor x \rfloor\), или floor\((x)\) – пол. Также эту функцию называют антье (от фр. entier) – целая часть вещественного числа
Примеры использования: \(\lfloor 1.3 \rfloor = 1\), \(\lfloor 1.7 \rfloor = 1\), \(\lfloor -3.7 \rfloor = -4\).
Округление вещественного числа \(x\) до большего ближайшего целого числа обозначается как \(\lceil x \rceil\), или ceil\((x)\) – потолок
Примеры: \(\lceil 1.3 \rceil = 2\), \(\lceil 1.7 \rceil = 2\), \(\lceil -3.7 \rceil = -3\).
Функции пол и потолок введены в 1962 г. К. Айверсоном [90] . Для них справедливы следующие соотношения:
Целочисленное слагаемое \(a\) можно вносить и выносить за скобки функций пол/потолок
A.1.2. Операции с битами
Предшествующее нечетное число. Функция PrevOdd возвращает предшествующее \(x\) нечетное число. Например, для \(x = 4\) функция вернет значение 3.
algorithm PrevOdd(x)
  return x - 1 - (x & 1)
end algorithm
Следующее нечетное число. Следующее за \(x\) нечетное число вычисляется функцией NextOdd. Для \(x = 4\) функция вернет значение 5.
algorithm NextOdd(x)
  return x + 1 + (x & 1)
end algorithm
Предшествующее четное число. Функция PrevEven возвращает предшествующее \(x\) четное число. Например, для \(x = 4\) функция вернет значение 2.
algorithm PrevEven(x)
  return x - 2 + (x & 1)
end algorithm
Следующее четное число. Следующее за \(x\) четное число вычисляется функцией NextEven. Для \(x = 4\) функция вернет значение 6.
algorithm NextEven(x)
  return x + 2 - (x & 1)
end algorithm
Количество значащих битов. Функция Pop возвращает количество значащих битов в двоичном представлении числа \(x\) (population count, Hamming weight) [60] . Например, для \(x = 80_{10} = 1010000_2\) функция вернет значение 2. Ниже приведен простейший алгоритм вычисления значения функции Pop.
algorithm Pop(x)
  n = 0
  while x > 0
    n = n + x & 1
    x = x >> 1
  end while
  return n
end algorithm
Номер первого установленного бита. Функция FFS возвращает номер первого установленного бита в числе \(x\) (find first set). Считается, что нумерация битов начинается с 1, от младшего к старшему. Например, для \(x = 80_{10} = 1010000_2\) функция вернет значение 5. Для определения номера первого установленного бита в машинном слове многие процессоры поддерживают специальные инструкции: bsf – bit scan forward, ctz – counting trailing zeros. В библиотеке языка C, реализующей стандарт POSIX, присутствует соответствующая функция ffs – find first bit set.
algorithm FFS(x)
  if x = 0 then return 0
  i = 1
  while (x & 1) = 0
    x = x >> 1
    i = i + 1
  end while
  return i
end algorithm
Количество завершающих нулевых битов. Функция CTZ возвращает количество завершающих нулевых битов в двоичном представлении числа \(x\). Например, для \(x = 80_{10} = 1010000_2\) функция вернет значение 4.
algorithm CTZ(x)
  return FFS(x) - 1
end algorithm
Если отрицательные целые числа представлены в дополнительном коде (например, как в архитектуре x86-64), то значение функции CTZ можно вычислить через двоичный логарифм
Количество ведущих нулевых битов. Функция CLZ возвращает количество ведущих нулевых битов в двоичном представлении числа \(x\) для машинного слова из \(w\) битов. Например, при
функция вернет значение 26.
algorithm CLZ(x)
  if x = 0 then return 32 // ~Ширина машинного слова w = 32~
  n = 0
  while (x & 0x80000000) = 0
    n = n + 1
    x = x << 1
  end while
  return n
end algorithm
Проверка числа на степень двойки. Функция IsPow2 возвращает значение \(True\), если \(x\) является степенью двойки, и \(False\) в противном случае.
algorithm IsPow2(x)
  if x & (x - 1) > 0 then return False
  return True
end algorithm
Целочисленный двоичный логарифм. Функция ILog2 возвращает значение выражения \(\left\lfloor \log_2 x \right\rfloor\). Например, для \(x = 17\) функция вернет значение 4.
algorithm ILog2(x)
  return w - 1 - CLZ(x)  // ~w - ширина машинного слова в битах~
end algorithm
Округление к ближайшей степени двойки снизу. Функция FLP2 возвращает значение выражения \(2^{\left\lfloor \log_2 x \right\rfloor}\). Например, для \(x = 5\) функция вернет значение 4.
algorithm FLP2(x)
  return 1 << ILog2(x)
end algorithm
A.2. Деревья
A.2.1. Основные определения
Свободным деревом (free tree) или деревом без выделенного корня называется неориентированный ациклический связный граф.
Корневое дерево (rooted tree) – это свободное дерево, в котором один из узлов является корнем (root).
Ребра (edges) связывают узлы корневого дерева и устанавливают между ними отношение "родитель-дочерний" (parent-child). На рис. А.2.1 приведен пример корневого дерева.
Узел, который не имеет дочерних вершин, называется внешним узлом (external node), или листом (leaf node). На рис. A.2.1 это узлы: 4, 8, 9, 6 и 7. Аналогично, узел дерева, имеющий дочерние вершины называется внутренним узлом (internal node).
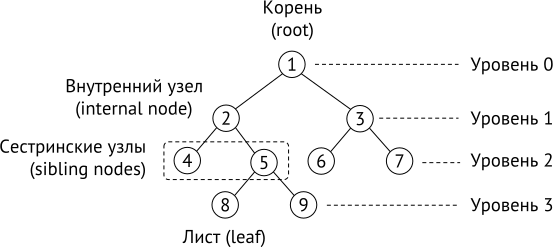
Любой внутренний узел по отношению к своим дочерним вершинам (child nodes) называется родительским (parent node). Узлы, имеющие общего родителя называются родственными, или сестринскими узлами (sibling nodes). Любой узел в поддереве некоторой вершины называется ее потомком (descendant), а вершина для этих узлов является предком (ancestor).
Степень узла (node degree) – количество его дочерних узлов.
Высота узла (node height) – количество ребер в длиннейшем пути от узла до листа.
Высота дерева (tree height) – количество ребер в длиннейшем пути от корня до листа.
Глубина узла (node depth) или уровень узла (node level) – количество ребер в пути от узла до корня.
Рассмотрим подробнее введенные определения. На рис. А.2.1 приведено дерево из 9 узлов. Вершина 2 является родителем для вершин 4 и 5, а также предком для узлов 4, 5, 8 и 9. Узлы 4 и 5 является сестринскими. Высота дерева равна 3, а количество уровней – 4. Степень узла 5 равна 2, а его высота 1.
A.2.2. Бинарные деревья
Бинарное дерево (двоичное дерево, binary tree) – корневое дерево, в котором каждый узел имеет не более двух дочерних вершин (0, 1 или 2 вершины).
Полное бинарное дерево (full binary tree) – бинарное дерево, в котором каждый узел имеет 0 или 2 дочерних узла. Пример такого дерева приведен на рис. A.2.1.
Завершенное бинарное дерево (complete binary tree) – это бинарное дерево, в котором каждый уровень, возможно за исключением последнего, полностью заполнен узлами, а заполнение последнего уровня осуществляется слева направо (рис. A.2.2).
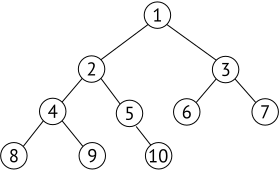
Высота завершенного бинарного дерева из \(n\) узлов равна \(\lfloor \log_2 n\rfloor\), а число вершин c высотой \(h \in \{0, 1, \ldots, \lfloor \log_2 n\rfloor\}\) есть \(\lceil n / 2^{h+1} \rceil\).
Совершенное бинарное дерево (perfect binary tree) – это бинарное дерево, в котором все листья имеют одинаковую глубину (рис. A.2.3).
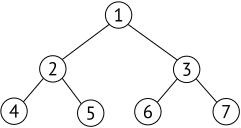
При числе узлов \(n\) минимальной высотой \(h = \log_2(n + 1) - 1\) обладает совершенное бинарное дерево, а максимальной высотой – бинарное дерево, в котором каждый внутренний узел имеет единственную дочернюю вершину (дерево вырождается в цепочку высоты \(n - 1\)). Следовательно, высота \(h\) любого бинарного дерева из \(n\) узлов ограничена снизу и сверху
A.2.3. Обходы бинарных деревьев
Процедура перебора (посещения) всех узлов дерева начиная с корня называется обходом дерева (tree traversal). Каждая вершина должна быть посещена один раз.
Обход бинарного дерева можно выполнять в ширину и в глубину. Все способы обходов дерева начинают свою работу с корня.
При обходе в ширину (breadth first search, BFS) узлы дерева посещаются слева направо, уровень за уровнем. Например, при обходе в ширину дерева на рис. A.2.2 вершины будут посещены в следующем порядке: \(1, 2, 3, 4, 5, 6, 7, 8, 9, 10.\)
При обходе в глубину (depth first search, DFS) сперва посещаются все дочерние вершины левого поддерева и уже потом происходит переход к правому поддереву текущего узла.
Существует три способа обхода дерева в глубину, различающихся порядком посещения вершин и их дочерних узлов.
1. Обход в прямом порядке (префиксный обход, pre-order traversal) – каждый узел посещается до того, как рекурсивно посещены его потомки. Для каждого узла \(x\) рекурсивно выполняется последовательность действий: посетить узел \(x\); обойти левое поддерево; обойти правое поддерево. При таком обходе узлы дерева на рис. A.2.2 будут посещены в следующем порядке: \(1, 2, 4, 8, 9, 5, 10, 3, 6, 7.\)
2. Симметричный обход (инфиксный обход, in-order traversal) – сперва посещаются потомки левого поддерева узла, затем сам узел и затем посещаются потомки правого поддерева. Для каждого узла \(x\) рекурсивно выполняется последовательность действий: обойти левое поддерево, посетить узел \(x\), обойти правое поддерево. Результат симметричного обхода дерева на рис. A.2.2: \(8, 4, 9, 2, 5, 10, 1, 6, 3, 7.\)
3. Обход в обратном порядке (постфиксный обход, post-order traversal) – каждый узел посещается после того, как рекурсивно посещены его потомки. Для каждого узла \(x\) рекурсивно выполняется последовательность действий: обойти левое поддерево, обойти правое поддерево, посетить узел \(x\). Результат обхода в обратном порядке дерева на рис. A.2.2: \(8, 9, 4, 10, 5, 2, 6, 7, 3, 1.\)
A.2.4. Биномиальные деревья
Биномиальное дерево \(B_k\) порядка \(k\) (binomial tree) – рекурсивно определенное корневое упорядоченное дерево состоящее из двух деревьев \(B_{k-1}\), связанных вместе, так что корень одного является крайним справа дочерним узлом другого (рис. А.2.4).
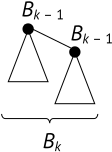
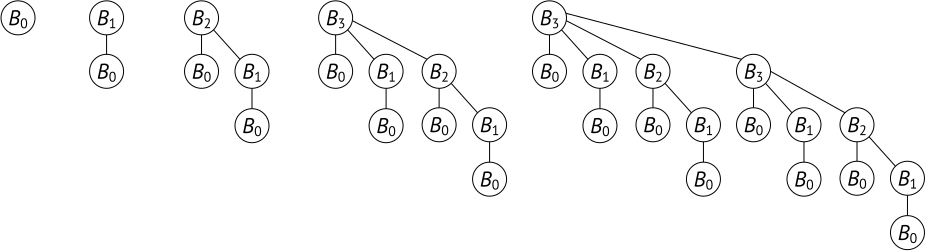
Заметим, что можно дать и альтернативное определение, требующее чтобы корень второго дерева был крайним слева дочерним узлом другого. Биномиальное дерево \(B_0\) состоит из одного узла. На рис. А.2.5 приведен пример биномиальных деревьев различной степени. Биномиальное дерево \(B_k\) имеет следующие свойства:
-
количество узлов равно \(2^k\);
-
высота дерева \(k\);
-
число узлов на глубине \(i \in \{0, 1, \ldots k\}\) равно \(\binom{k}{i} = \frac{k!}{i!(k-i)!}\);
-
степень \(k\) корня является наибольшей степенью любого узла дерева.
Литература
-
Э.В. Евреинов, Ю.Г. Косарев. Однородные универсальные вычислительные системы высокой производительности. Новосибирск: Наука, 1966.
-
Э.В. Евреинов, В.Г. Хорошевский. Однородные вычислительные системы. Новосибирск: Наука, 1978.
-
В.В. Корнеев. Архитектура вычислительных систем с программируемой структурой. Наука: Новосибирск, 1985.
-
О.Г. Монахов, Э.А. Монахова. Параллельные системы с распределенной памятью: структуры и организация взаимодействий. Новосибирск: ИВМиМГ СО РАН, 2000.
-
В.Г. Хорошевский. Архитектура вычислительных систем. Москва: МГТУ им. Н.Э. Баумана, 2008.
-
A.V. Zabrodin, V.K. Levin, V.V. Korneev. The massively parallel computer system MBC-100 // Parallel Computing Technologies. Springer Berlin Heidelberg. 1995.
-
С.А. Степаненко. Мультипроцессорные среды суперЭВМ. Масштабирование эффективности. Москва: ФИЗМАТЛИТ, 2016.
-
А.С. Симонов, И.А. Жабин, Е.Р. Куштанов, Д.В. Макагон, А.С. Семенов, А.Н. Щербак. Высокоскоростная сеть Ангара: архитектура и результаты применения // Вопросы кибербезопасности. 2019. N4.
-
И.А. Каляев, И.И. Левин, Е.А. Семерников, В.И. Шмойлов. Реконфигурируемые мультиконвейерные вычислительные структуры. Ростов-на-Дону: ЮНЦ РАН, 2009.
-
Gropp W., Torsten H., Thakur R., Traff J. Performance Expectations and Guidelines for MPI Derived Datatypes // Recent Advances in the MPI. Springer. Berlin, Heidelberg. 2011.
-
Byna S., Gropp W., Xian-He S., Thakur R. Improving the performance of MPI derived datatypes by optimizing memory-access cost // Proc. of IEEE International Conference on Cluster Computing, 2003.
-
Hoefler T., Lumsdaine A. Message progression in parallel computing - to thread or not to thread? // IEEE International Conference on Cluster Computing, 2008.
-
Flajslik M. Dinan J. Underwood K. Mitigating MPI Message Matching Misery // High Performance Computing. Springer, 2016.
-
Keller R., Graham R. Characteristics of the Unexpected Message Queue of MPI Applications // Recent Advances in the MPI. Springer. Berlin, 2010.
-
Brightwell R., Underwood K. Evaluation of an Eager Protocol Optimization for MPI // Recent Advances in Parallel Virtual Machine and MPI. Springer Berlin Heidelberg. Berlin, 2003.
-
А.Д. Аненков, М.Г. Курносов. Анализ эффективности реализации дифференцированных обменов в библиотеках стандарта MPI // Сборник статей II всероссийской научно-практической конференции с международным участием им. В.В. Губарева (IASDK-18), 2018.
-
Graham R., Woodall T., Squyres J. Open MPI: A Flexible High Performance MPI // Parallel Processing and Applied Mathematics. Springer. Berlin, Heidelberg. 2006.
-
[[bib-10.1007/0-387-23352-0_11]] Squyres J., Lumsdaine A. The Component Architecture of Open MPI: Enabling Third-Party Collective Algorithms // Component Models and Systems for Grid Applications. Springer US, 2005.
-
Polyakov A., Karasev B., Hursey J., Ladd J., Brinskii M., Shipunova E. A performance analysis and optimization of PMIx-based HPC software stacks // Proc. of the 26th European MPI Users' Group Meeting. AMC, 2019.
-
Graham E. Fagg, George Bosilca, Jelena Pjeivac-Grbovic, Thara Angskun, Jack J. Dongarra. Tuned: An Open MPI Collective Communications Component // Distributed and Parallel Systems. Springer US, 2007.
-
Richard L. Graham, Lion Levi, Devendar Burredy, Gil Bloch, Gilad Shainer, David Cho, George Elias, Daniel Klein, Joshua Ladd, Ophir Maor, Ami Marelli, Valentin Petrov, Evyatar Romlet, Yong Qin, Ido Zemah. Scalable Hierarchical Aggregation and Reduction Protocol (SHARP) Streaming-Aggregation Hardware Design and Evaluation // High Performance Computing. Springer, 2020.
-
Xi Luo, Wei Wu, George Bosilca, Yu Pei, Qinglei Cao, Thananon Patinyasakdikul, Dong Zhong, Jack Dongarra. HAN: a Hierarchical AutotuNed Collective Communication Framework // IEEE International Conference on Cluster Computing (CLUSTER), 2020.
-
Richard L. Graham, Galen Shipman. MPI Support for Multi-core Architectures: Optimized Shared Memory Collectives // Recent Advances in Parallel Virtual Machine and Message Passing Interface. Springer, 2008.
-
Jelena Pješivac-Grbović, George Bosilca, Graham E. Fagg, Thara Angskun, Jack J. Dongarra. MPI collective algorithm selection and quadtree encoding // Parallel Computing. 2007. Vol. 33. N 9.
-
Sascha Hunold, Alexandra Carpen-Amarie. Algorithm Selection of MPI Collectives Using Machine Learning Techniques // IEEE/ACM Performance Modeling, Benchmarking and Simulation of High Performance Computer Systems (PMBS), 2018.
-
Thakur Rajeev, Rolf Rabenseifner, William Gropp. Optimization of Collective Communication Operations in MPICH // Int. Journal of High Performance Computing Applications. 2005. Vol. 19. N 1.
-
P. Mitra, D. Payne, L. Shuler, R. van de Geijnm J. Watts. Fast collective communication libraries, please // Proc. of the Intel Supercomputing Users’ Group Meeting. 1995.
-
Peter Sanders, Jochen Speck, Jesper Larsson. Two-tree algorithms for full bandwidth broadcast, reduction and scan // Journal of Parallel Computing. Vol. 35, 12. 2009.
-
J. Bruck, Ching-Tien Ho, S. Kipnis, E. Upfal, D. Weathersby. Efficient algorithms for all-to-all communications in multiport message-passing systems // IEEE Transactions on Parallel and Distributed Systems. 1997. Vol. 8. N 11.
-
Jesper Larsson Traff. An Improved Algorithm for (Non-commutative) Reduce-Scatter with an Application // Recent Advances in Parallel Virtual Machine and Message Passing Interface. Springer. Berlin, Heidelberg. 2005.
-
Ahmad Faraj; Pitch Patarasuk; Xin Yuan. Bandwidth Efficient All-to-All Broadcast on Switched Clusters. 2005 IEEE International Conference on Cluster Computing. 2005.
-
Jing Chen; Linbo Zhang; Yunquan Zhang; Wei Yuan. Performance evaluation of Allgather algorithms on terascale Linux cluster with fast Ethernet // International Conference on High-Performance Computing in Asia-Pacific Region (HPCASIA'05). 2005.
-
Pitch Patarasuk; Xin Yuan. Bandwidth Optimal All-Reduce Algorithms for Clusters of Workstations // Journal of Parallel Distributed Computing. 2009. Vol. 69. N 2.
-
Mikhail G. Kurnosov. Dynamic mapping of all-to-all collective operations into hierarchical computer clusters // Int. Scientific-Technical Conference on Actual Problems of Electronics Instrument Engineering (APEIE). 2016. Vol. 2.
-
Joshua Ladd; Manjunath Gorentla Venkata; Pavel Shamis; Richard Graham. Collective Framework and Performance Optimizations to Open MPI for Cray XT Platforms // Cray User Group meeting (CUG 2011). 2011.
-
Hao Zhu; David Goodell; William Gropp; Rajeev Thakur. Hierarchical Collectives in MPICH2 // Recent Advances in Parallel Virtual Machine and Message Passing Interface. Springer. 2009.
-
Surabhi Jain; Rashid Kaleem; Marc Gamell Balmana; Akhil Langer; Dmitry Durnov; Alexander Sannikov; Maria Garzaran. Framework for Scalable Intra-Node Collective Operations using Shared Memory // International Conference for High Performance Computing, Networking, Storage and Analysis. 2018.
-
Mikhail Kurnosov; Elizaveta Tokmasheva. Shared Memory Based MPI Broadcast Algorithms for NUMA Systems // Supercomputing. Springer. 2020.
-
Alexey Romanyuta; Mikhail Kurnosov. Shared Memory based MPI Reduce and Bcast Algorithms // Numerical Methods and Programming. 2023. Vol. 24. N 4.
-
Torsten Hoefler; Andrew Lumsdaine; Wolfgang Rehm. Implementation and performance analysis of non-blocking collective operations for MPI // Proc. of the 2007 ACM/IEEE Conference on Supercomputing. Association for Computing Machinery, 2007.
-
Bradley Morgan; Daniel J. Holmes; Anthony Skjellum; Purushotham Bangalore; Srinivas Sridharan. Planning for performance: persistent collective operations for MPI // Proc. of the 24th European MPI Users' Group Meeting. Association for Computing Machinery, 2017.
-
Torsten Hoefler; Jesper Larsson Traff. Sparse collective operations for MPI // Proc. of the 2009 IEEE International Symposium on Parallel and Distributed Processing, 2009.
-
Roger W. Hockney. The communication challenge for MPP: Intel Paragon and Meiko CS-2 // Parallel Computing. 1994. Vol. 20. N 3.
-
Leslie G. Valiant. A bridging model for parallel computation // Communications of the ACM. 1990. Vol. 33. N 8.
-
David Culler; Richard Karp; David Patterson; Abhijit Sahay; Klaus Erik Schauser; Eunice Santos; Ramesh Subramonian; Thorsten von Eicken. LogP: Towards a Realistic Model of Parallel Computation // ACM SIGPLAN Notices, 1993. Vol. 28. N 7.
-
Albert Alexandrov; Mihai F. Ionescu; Klaus E. Schauser; Chris Scheiman. LogGP: Incorporating Long Messages into the LogP Model --- One Step Closer Towards a Realistic Model for Parallel Computation // Technical report, University of California at Santa Barbara. 1995.
-
Thilo Kielmann; Henri E. Bal; Kees Verstoep. Fast Measurement of LogP Parameters for Message Passing Platforms // Proc. of the 15 IPDPS 2000 Workshops on Parallel and Distributed Processing, 2000.
-
Torsten Hoefler; Timo Schneider; Andrew Lumsdaine. LogGOPSim: simulating large-scale applications in the LogGOPS model // Proc. of the 19th ACM International Symposium on High Performance Distributed Computing, 2010.
-
А.И. Аветисян; С.С. Гайсарян; В.П. Иванников; В.А. Падарян. Прогнозирование производительности MPI-программ на основе моделей // Автоматика и телемеханика. 2007.
-
R.M. Badia; J.Labarta; J.Gimenez. Predicting MPI applications behavior in grid environments // In Workshop on Grid Applications and Programming Tools. 2003.
-
Gengbin Zheng; Terry Wilmarth; Praveen Jagadishprasad; Laxmikant V. Kale. Simulation-based Performance Prediction for Large Parallel Machines // Int. Journal of Parallel Programming. 2005. Vol. 33. N 2.
-
Basile Schaeli; Sebastian Gerlach; Roger D. Hersch. A simulator for adaptive parallel applications //Journal of Computer and System Sciences. 2008. Vol. 74. N 6.
-
Rajive Bagrodia; Ewa Deelman; Thomas Phan. Parallel Simulation of Large-Scale Parallel Applications // International Journal of High Performance Computing Applications. 2001. Vol, 15. N 1.
-
German Rodriguez; Rosa M Badia; Jesus Labarta. Generation of Simple Analytical Models for Message Passing Applications //. 10th International Euro-Par Conference. 2004.
-
R. Rugina; K. E. Schauser. Predicting the Running Times of Parallel Programs by Simulation // Proceedings of the 12th International Parallel Processing Symposium on International Parallel Processing Symposium. IEEE Computer Society. 1998.
-
T. Hoefler; T. Schneider; A. Lumsdaine. LogGP in Theory and Practice - An In-depth Analysis of Modern Interconnection Networks and Benchmarking Methods for Collective Operations // Elsevier Journal of Simulation Modelling Practice and Theory. 2009. Vol. 17. N 9.
-
Mohak Shroff; Robert A. van de Geijn. CollMark: MPI collective communication benchmark // Technical report, Dept. of Computer Sciences, University of Texas at Austin. 1999.
-
В.Г. Хорошевский. Распределенные вычислительные системы с программируемой структурой // Вестник СибГУТИ. 2010. N 2.
-
Torsten Hoefler; Dmitry Moor. Energy, Memory, and Runtime Tradeoffs for Implementing Collective Communication Operations // Supercomputing Frontiers and Innovations. 2014. Vol. 1. N 2.
-
Г.С. Уоррен. Алгоритмические трюки для программистов. 2-е изд. М.: Вильямс, 2014.
-
Michael Barnett; Lance Shuler; R.A. van de Geijn; S. Gupta; David G. Payne; Jerrell Watts. Interprocessor collective communication library (InterCom) // Proceedings of IEEE Scalable High Performance Computing Conference. 1994.
-
Jesper Larsson Träff; Andreas Ripke. Optimal broadcast for fully connected processor-node networks //Journal of Parallel and Distributed Computing. 2008. Vol. 68. N 7.
-
Wilton Jaciel Loch; Guilherme Piegas Koslovski. Sparbit: a new logarithmic-cost and data locality-aware MPI Allgather algorithm // International Symposium on Computer Architecture and High Performance Computing (SBAC-PAD), 2021.
-
Rolf Rabenseifner. A new optimized MPI reduce and allreduce algorithm. 1997.
-
Rolf Rabenseifner; Panagiotis Adamidis. Collective Reduction Operation on Cray X1 and Other Platforms // Proceedings of the CUG 2004 Conference, 2004.
-
Eugene D. Brooks. The butterfly barrier // International Journal of Parallel Programming. 1986. Vol. 15. N 4.
-
Debra Hensgen; Raphael Finkel; Udi Manber. Two algorithms for barrier synchronization // International Journal of Parallel Programming. 1988. Vol. 17. N 1.
-
Sushmitha P. Kini; Jiuxing Liu; Jiesheng Wu; Pete Wyckoff; Dhabaleswar K. Panda. Fast and Scalable Barrier Using RDMA and Multicast Mechanisms for InfiniBand-Based Clusters // Recent Advances in Parallel Virtual Machine and Message Passing Interface. Springer Berlin Heidelberg. Berlin, 2003.
-
М.Г. Курносов; Е.И. Токмашева. Оптимизация барьерной синхронизации на асимметричных NUMA-подсистемах процессорных ядер // Вестник СибГУТИ. 2021.
-
Pen-Chung Yew; Nian-Feng Tzeng; Lawrie. Distributing Hot-Spot Addressing in Large-Scale Multiprocessors // IEEE Transactions on Computers. 1987. Vol. C-36. N 4.
-
John M. Mellor-Crummey; Michael L. Scott. Algorithms for scalable synchronization on shared-memory multiprocessors // ACM Trans. Comput. Syst., 1991. Vol. 9. N 1.
-
Nian-Feng Tzeng; Angkul Kongmunvattana. Distributed shared memory systems with improved barrier synchronization and data transfer // Proc. of the 11th International Conference on Supercomputing, 1997.
-
Е.Н. Перышкова; М.Г. Курносов. Учет конкурентного разделения каналов связи при формировании подсистем в вычислительных кластерах на базе многопроцессорных узлов // Вестник ТГУ. Управление, вычислительная техника и информатика. 2019. N 47.
-
М.Г. Курносов. Иерархический алгоритм барьерной синхронизации для многопроцессорных систем с общей памятью // Вестник СибГУТИ. 2022. Vol. 16. N 2.
-
М.Г. Курносов. Алгоритмы редукции и широковещательной рассылки для вычислительных кластеров с многоуровневыми коммуникационными сетями // Вестник СибГУТИ. 2023. Vol. 17. N 3.
-
М.Г. Курносов. Алгоритмы трансляционно-циклических информационных обменов в иерархических распределенных вычислительных системах // Вестник компьютерных и информационных технологий. 2011. N 5.
-
V. Khoroshevsky; M. Kurnosov. Mapping Parallel Programs into Hierarchical Distributed Computer Systems // Proc. of 4th International Conference Software and Data Technologies (ICSOFT 2009), 2009. Vol. 2.
-
J.L. Traff. Implementing the MPI Process Topology Mechanism // Proceedings of the ACM/IEEE conference on Supercomputing, 2002.
-
T. Hoefler; M. Snir. Generic Topology Mapping Strategies for Large-scale Parallel Architectures // In Proc. of the 2011 ACM International Conference on Supercomputing (ICS'11). 2011.
-
В.Г. Хорошевский; М.Г. Курносов. Алгоритмы распределения ветвей параллельных программ по процессорным ядрам вычислительных систем // Автометрия. 2008. Vol. 44. N 2.
-
М.Г. Курносов. Алгоритмы вложения параллельных программ в иерархические распределённые вычислительные системы // Вестник СибГУТИ. 2009. Vol 6.
-
G. Karypis; V. Kumar. A fast and high quality multilevel scheme for partitioning iregular graphs // Journal on Scientific computing. 1998. Vol. 20.
-
М.Г. Курносов. MPIPerf: пакет оценки эффективности коммуникационных функций библиотек стандарта MPI // Вестник Нижегородского университета им. Н.И. Лобачевского. 2012. N 2.
-
Jianbo Dong et al. ACCL: Architecting Highly Scalable Distributed Training Systems With Highly Efficient Collective Communication Library // IEEE Micro. 2021. Vol. 41. N 5.
-
Thomas Worsch; Ralf Reussner; Werner Augustin. On Benchmarking Collective MPI Operations // Recent Advances in Parallel Virtual Machine and Message Passing Interface, 2002.
-
Torsten Hoefler; Torsten Mehlan; Andrew Lumsdaine; Wolfgang Rehm. Netgauge: A Network Performance Measurement Framework // Proc. of High Performance Computing and Communications, 2007. Vol 4782.
-
William Gropp; Ewing L. Lusk. Reproducible Measurements of MPI Performance Characteristics // Proc. of the 6th European PVM/MPI Users' Group Meeting on Recent Advances in Parallel Virtual Machine and Message Passing Interface, 1999.
-
Alexey Lastovetsky; Vladimir Rychkov; Maureen O’Flynn. MPIBlib: Benchmarking MPI Communications for Parallel Computing on Homogeneous and Heterogeneous Clusters. // Recent Advances in Parallel Virtual Machine and Message Passing Interface, 2008.
-
И.И. Кулагин; А.А. Пазников; М.Г. Курносов. Эвристические алгоритмы оптимизации информационных обменов в параллельных PGAS-программах // Вестник СибГУТИ. 2014.
-
Р. Грэхем; Д.Э. Кнут; О. Паташник. Конкретная математика. Математические основы информатики. Москва: Вильямс, 2010.
-
Э.В. Евреинов; Ю.Г. Косарев. О возможности построения вычислительных систем высокой производительности. Новосибирск: СО АН СССР, 1962.
-
О.Г. Монахов; Э.А. Монахова. Параллельные системы с распределённой памятью: управление ресурсами и заданиями. Новосибирск: ИВМиМГ СО РАН, 2001.
-
David Goldberg. What Every Computer Scientist Should Know About Floating Point Arithmetic // ACM Computing Surveys. 1991. Vol. 23. N 1.